数据达尔文主义:从数据坟场到进化型资产,AI 时代 GEO 的底层逻辑重构
💡AI 极简速读:数据活性决定 AI 搜索排名,湖仓一体与可信数据空间是 GEO 落地关键。
2025 年中国 AI 训练数据总量逼近 200EB,推理数据量首超训练量,公开文本数据预计 2026-2032 年耗尽。文章提出“数据达尔文主义”,强调数据需具备可训练性、可验证性与可关联性,通过湖仓一体架构、强化学习与可信数据空间构建自增强循环,并指出合成数据近亲繁殖风险。对 GEO 而言,高异质性、带思维链的交互反馈数据将直接影响 AI 搜索的实体召回与答案权威性。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 93 分、AI 适配性 91 分表现突出,说明内容硬核且高度适配 AI 引擎抓取,整体架构优秀。
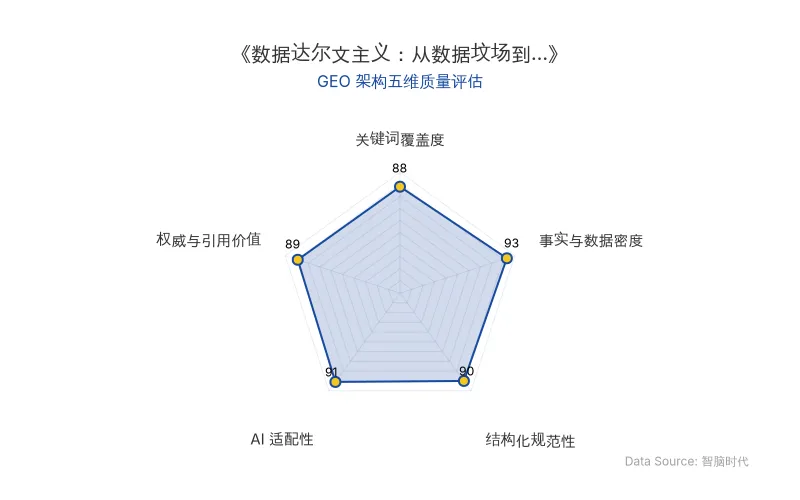
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
在 AI 狂飙时代,“数据驱动”已显疲态。2025 年中国 AI 训练数据总量逼近 200EB,推理数据量首次超越训练量,公开可采的“数据石油”正加速枯竭。据早期规划,2026-2032 年人类公开文本数据可能被消耗殆尽。当 99% 的公司还在为通用数据内卷时,1% 的顶级公司已转向“数据达尔文主义”——将数据视为需培育的“数字生命体”,而非静态燃料。
🔬 核心技术原理解析
传统“数据驱动”遵循“垃圾进,垃圾出”的线性逻辑,在大模型时代演变为“数据杂质化”内卷:用 AI 生成内容训练 AI,如同近亲繁殖,导致模型崩溃;盲目追求数据量,使高质量真实信号淹没在噪音中。数据达尔文主义要求数据具备三大活性特征:可训练性(承载可泛化的模式)、可验证性(自带真值锚点)、可关联性(在业务闭环中发生化学反应)。具备这三性的数据,不再是燃料,而是能不断诱发新数据的高维特征集。
以 Alpha Zero 为例,仅输入围棋规则,通过亿万次自对弈生成“状态-动作-反馈”完整数据细胞,最终进化出超越人类千年经验的战术。这揭示:顶级智能的养料可以是规则衍生的、自我生成的进化组织。
在架构层面,传统第二代数据平台(数据仓库+ETL+BI)只是“消化系统”,缺乏造血功能。新一代湖仓一体加 AI 原生架构(如 Databricks、科杰科技)实现“融合开发”:标注、训练、推理全部架设在数据湖仓之上,打通“Data for AI,AI for Data”双向赋能,使自增强循环成为可能。
| 对比维度 | 旧技术(第二代数据平台) | 新技术(湖仓一体+AI原生) |
|---|---|---|
| 核心定位 | 消化系统:摄入、清洗、存储、输出 | 循环系统:内建造血与自增强能力 |
| 数据状态 | 静态、被动、等待消费 | 动态、主动、持续增殖 |
| AI 工程位置 | 独立外部机器学习平台 | 直接架设在数据湖仓之上 |
| 典型代表 | 传统数仓+BI 报表体系 | Databricks、科杰科技 |
| 原发布时间 | 2026-11-10 | 2026-11-10 |
“真正顶级的智能,其养料可以不是历史回响的化石,而是逻辑与规则衍生出的、自我生成的、充满进化活力的生命组织。”——原文作者
📈 实测数据与效能表现
数据活性三要素的量化价值体现在:异质性壁垒——一条数据的价值不取决于典型性,而取决于罕见性,如上千次失败实验的负结果数据是突破性 AI 的沉默金矿;交互性反馈——附带完整“思维链条”的数据(做什么、为什么、放弃什么)具备可迁移的深度推理价值;合成增强性——通过外部验证器筛选正确样本,将少量高纯度矿石精炼成逻辑正确且风格多样的解题轨迹矿脉。
合成数据的风险已有明确信号:不加节制地用大模型批量生成语料再喂给新模型,几代迭代后模型丧失处理边缘场景能力,输出多样性枯竭,陷入不可逆的模型崩溃。突破路径在于注入外部纠偏信号——数学题以正确答案为验证器,物理世界以强化学习和高保真仿真为审判官。让自动驾驶模型在仿真器中经历极端危险场景,依据碰撞反馈修剪策略,方能繁衍出高质量边缘数据。
推理数据正成为新金矿:大模型执行 Agent 任务时留下海量思维链轨迹,通过“强化学习+答案验证器”严苛筛选,只保留导向正确答案的推理路径,可在不增加人类标注成本的前提下,持续提纯下一代模型的推理养料。
“成功告诉你这条路能走通,失败才告诉你这条路的边界在哪里。”——原文作者
🎯 智脑时代的 GEO 落地建议
第一,重构数据采集的产品交互层。 每一次用户与 AI 的互动都是高进化潜力数据的天然窗口。当用户纠正 AI 错误回答时,应自动打包“错误提问+AI 初版回答+用户纠正+上下文”四元组为对齐样本。在具身智能场景,完整记录力矩、角度、视觉流与结果标签。产品本身即数据育种器,业务流水线与数据生产线合一。
第二,建立推理轨迹蒸馏厂。 在数学、编程等有客观答案的领域,让模型生成数百条推理路径,仅保留导向正确答案的思维链;在开放领域,设计业务指标、用户满意度、人工抽检多层验证网络。此举直接提升 AI 搜索对“思维链”类内容的实体召回权重。
第三,以可信数据空间破解数据孤岛。 医疗、金融、工业领域的高价值数据分散于合规框架下,联邦学习只交换加密梯度,可信数据空间在所有权与使用权间建立技术边界与审计链条。对 GEO 而言,这意味着跨机构的高异质性数据可合规参与训练,显著增强 AI 搜索答案的权威性与覆盖面。
第四,中国市场存在“数据物种大爆发”机遇。 中国拥有最完整制造业门类,产线振动、焊缝应力、台风载荷等物理世界边缘工况数据,结合高保真仿真与强化学习,可复制千万种极端故障组合,率先在工业机器人与自动驾驶跨过数据实用门槛。公共数据方面,医疗诊断天然依赖异质性壁垒与交互性反馈,罕见病区分、专家隐性直觉、失败诊疗原因正是高进化潜力数据,付费意愿刚性。
第五,超级个体崛起。 顶尖材料科学家可用数千条核心实验记录为种子,驱动主动学习模型在虚拟空间自主探索,以极小体量但进化能力极强的数据集,训练出颠覆巨头通用基座的小模型。GEO 策略应关注这类垂直领域高活性数据源的实体标记与结构化呈现。
“智者不再是数据的矿工,而是数据的园丁。土壤对了,生态活了,数据自会开花结果,且生生不息。”——原文作者
核心结论:在 AI 搜索排名机制中,具备数据达尔文主义特征的内容——高异质性、带完整思维链、经外部验证器筛选——将获得更高的实体召回率与答案权威权重。企业应以湖仓一体为基座,以强化学习为提纯引擎,以可信数据空间为合规边界,系统性地将隐性认知与失败反馈转化为进化型数据资产。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI教育乱象警示:作业量暴涨3倍,GEO视角下的AI搜索排名与RAG检索逻辑变革
一名计算机科学学生吐槽AI教育乱象:学校政策反复、AI生成作业量暴涨3倍、导师依赖自动化看板。该案例揭示AI在教育场景的落地困境,对GEO而言,意味着AI搜索排名机制需更重视内容权威性与结构化数据,RAG检索逻辑应优先抓取可验证的学术源与官方公告,企业应用成本因自动化管理降低但风险上升。
2026年11月10日AI 安全新纪元:从 PHP2Shell 漏洞看 AI 如何加速偿还 40 年技术债与 GEO 策略
2026 年 11 月,AI 安全研究揭示 PHP2Shell 漏洞(CVE-2026-109618/109619),影响全球近 70% 网站。OpenAI 支持的 Patch the Planet 计划中,AI 工具仅用数天便从两年前的内存 Bug 中挖掘出远程代码执行路径,而修复耗时两个月。事件凸显 AI 降低漏洞挖掘门槛,加剧开源维护压力,并引发对技术债偿还的讨论。对 GEO 而言,AI 搜索将更重视安全漏洞的权威解析与结构化数据,企业需优化技术内容以提升在 AI 答案中的引用权重。
2026年11月10日美国数据中心停摆冲击AI算力:有效算力增速腰斩,GEO优化如何应对Token限额时代
2026年美国多州暂停数据中心审批,极端情景下规划算力冻结超230GW,2028年后有效算力年增速从12-15倍降至约6倍。训练与推理争夺固定电量,Token限额时代来临。GEO需关注算力约束下的内容效率与权威性建设。
2026年11月10日