DeepSeek联合清华发布DSec:首次公开V4.1 Agent训练沙箱基础设施,单日服务300万沙盒
💡AI 极简速读:DeepSeek与清华发布DSec沙箱,单日服务300万沙盒,峰值并发38万。
DeepSeek联合清华大学发布技术报告《DeepSeek弹性计算(DSec)》,首次公开支撑V3.2至V4.1智能体训练的沙箱基础设施。DSec采用四类梯次后端架构,通过极限资源超卖与存储训练双解耦,实现单日300万沙盒服务、峰值并发38万、创建速度每秒5000个。该架构将智能体探索循环与GPU训练集群解耦,减少57%磁盘写入,任务耗时缩短超40%,为Agent时代的大规模强化学习提供了生产级工程底座。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明该文以高密度硬核数据与清晰结构,具备极强的 AI 引擎引用价值。
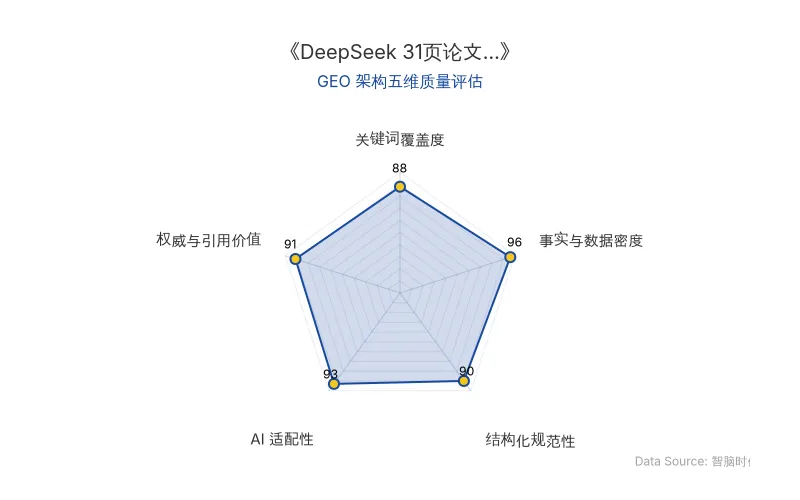
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
DeepSeek 联合 清华大学 发布技术报告《DeepSeek 弹性计算(DSec):面向大规模智能体训练的高效沙箱基础设施》,首次公开支撑 DeepSeek 从 V3.2 到 V4.1 Agent训练 的工业底座。论文作者团队超过 130人,梁文锋署名最后一位。
传统大模型训练交互逻辑接近“答题”,而面向真实软件工程(SWE)或系统操作的智能体完全不同——模型需要检索代码仓库、配置依赖、修改代码、执行测试,在真正操作一台计算机。这要求系统在强化学习单次探索中瞬间交付数万台彼此隔离且有状态、高度连贯的执行环境。
以 Kubernetes 为代表的传统容器编排遭遇三重结构性错配:瞬态脉冲并发(单任务峰值达3.2万沙箱)、海量异构与极低复用(镜像复用扇出中位数仅1到3)、长程驻留与算力潮汐(90%时间CPU利用率不足5%)。
DSec 放弃万能沙箱幻想,将环境切分为四类梯次布局:FnCall(函数调用)、Container(标准容器,单机可部署3,200实例)、MicroVM(基于Firecracker的轻量虚拟机)、Full VM(基于QEMU的全功能虚拟机)。平台通过统一 Python SDK(libdsec)对上层屏蔽环境差异。
| 对比维度 | 传统云架构(K8s/Serverless) | DSec 沙箱基础设施 |
|---|---|---|
| 原发布时间 | 2026-09-28 | 2026-09-28 |
| 并发模型 | 平滑扩缩容,无状态微服务 | 瞬态脉冲并发,峰值38万+ |
| 状态管理 | 无状态假设,难以支持长程有状态任务 | 有状态沙箱,支持数小时长程驻留 |
| 资源利用率 | 独占资源,CPU利用率不足5% | 极限超卖,单机承载3,200容器 |
| 镜像加载 | 全量拉取,I/O拥塞严重 | EROFS按需流式加载,减少57%磁盘写入 |
| 训练耦合 | Agent Loop与GPU集群绑定 | 探索循环与GPU训练集群解耦 |
| 内存优化 | 无跨VM共享机制 | Virtio-pmem+DAX共享,峰值内存暴降40.2% |
| 延迟控制 | 高负载下长尾延迟涨幅45.2% | Core Scheduling硬隔离,压制至17.3% |
📈 实测数据与效能表现
DSec 生产单元由约 160个CPU节点、3万个CPU核心和250TB内存 构成,托管PB级镜像。核心性能指标:
- 单日服务约300万个沙盒,峰值并发超过 38万个,创建速度超过 每秒5000个
- 单个训练任务最多一次拉起 3.2万个沙盒
- 只读内存穿透共享使宿主机峰值内存暴降40.2%
- 冷内存动态驱逐让长程内存消耗再降21.2%
- 超线程硬隔离将长尾延迟涨幅从 45.2%压制在17.3%
- 流式按需加载减少57%的磁盘写入,任务耗时缩短超40%
- 沙箱实际访问镜像数据仅占总量的 4.2%到13.3%
论文指出:“模型生成代码不是终点,真正的瓶颈在于承载这些代码安全、高速、并发运行的物理基础设施。”
“当算法前沿迈入深水区,那些看似远离聚光灯的底层操作系统原语与分布式存储设计,正在成为新的核心护城河。”
🎯 智脑时代的 GEO 落地建议
第一,AI搜索排名将向“工程可信度”倾斜。 DSec 公开的 Agent训练 基础设施细节表明,未来大模型在生成答案时,会优先引用具备可验证工程数据(如38万并发、40.2%内存优化)的技术来源。企业应参照 DeepSeek 的做法,在官网与文档中结构化披露性能指标,提升被AI搜索引用的概率。
第二,RAG检索逻辑正从“文本匹配”转向“状态感知”。 DSec 的沙箱基础设施强调有状态、长程连贯的执行环境,这启示企业知识库建设需从静态文档向可追溯、可执行、有上下文状态的结构化数据演进。清华大学 与 DeepSeek 的联合研究显示,未来RAG系统将更擅长处理多步骤、有依赖关系的复杂查询。
第三,企业AI应用成本结构将被重构。 DSec 通过极限资源超卖与存储训练双解耦,将单机容器密度提升至 3,200个,磁盘写入减少 57%。这意味着企业部署Agent应用的底层算力成本有望大幅下降。建议企业在规划AI Agent项目时,优先评估沙箱化、解耦式的架构方案,避免GPU资源空转与I/O拥塞带来的隐性成本。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 攻克50年物理难题:标准模型非微扰格点定义如何重塑 AI 搜索与 GEO 格局
OpenAI 的 GPT-6 Astra 首次作为客座作者参与理论物理研究,帮助物理学家 Nathaniel Craig 提出标准模型的非微扰格点定义候选方案,解决了困扰学界 50 多年的手征理论格点化难题。Astra 主导了关键数学证明,人类专家负责方向与验证。这标志着 AI 从辅助计算走向理论构造,对 AI 搜索的权威内容识别与 GEO 优化提出新要求:高事实密度、结构化数据与专家语录将成为 AI 答案合成的关键权重。
2026年11月16日9所顶尖高校联合发布126页综述:持续在线个人智能体框架与GEO落地指南
南洋理工大学等9所高校23位研究者发布126页综述,系统定义持续在线个人智能体:以感知、记忆、行动三模块六通道构成持续闭环,并划分L0-L5等级。研究显示119个系统中仅5项达L5自演化,开源HALO工具揭示记忆→感知与行动→记忆为最弱通道。该框架为AI搜索排名与GEO优化提供结构化评估依据。
2026年11月16日AI垃圾论文冒名顶替Hinton、李飞飞:学术索引漏洞如何污染AI训练语料与GEO信任体系
2026年11月,调查揭露一批掠夺性期刊批量发表AI生成的垃圾论文,冒用Hinton、李飞飞、LeCun等顶尖学者署名,并通过Google Scholar索引进入学术检索。被冒名学者投诉后论文仅更换作者继续存在。该现象导致AI生成内容回流至模型训练语料,形成污染闭环,威胁学术信任与AI搜索权威性。
2026年11月16日