Figure AI Helix 2.5 零样本泛化突破:56%成功率如何重构具身智能GEO格局
💡AI 极简速读:Figure Helix 2.5零样本泛化成功率从9%跃升至56%,Index预训练驱动具身智能Scaling Law。
Figure AI发布Helix 2.5,搭载Figure 03,在30户陌生家庭实现零样本全身泛化,任务成功率从9%提升至56%。核心技术为Index预训练数据集与双系统架构,首次验证人形机器人Scaling Law。国内宇树、智元、千寻智能等泛化指标分散,行业缺乏统一评测标尺。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,权威与引用价值 88 分亦属上乘,整体架构具备极强的AI引擎引用潜力。
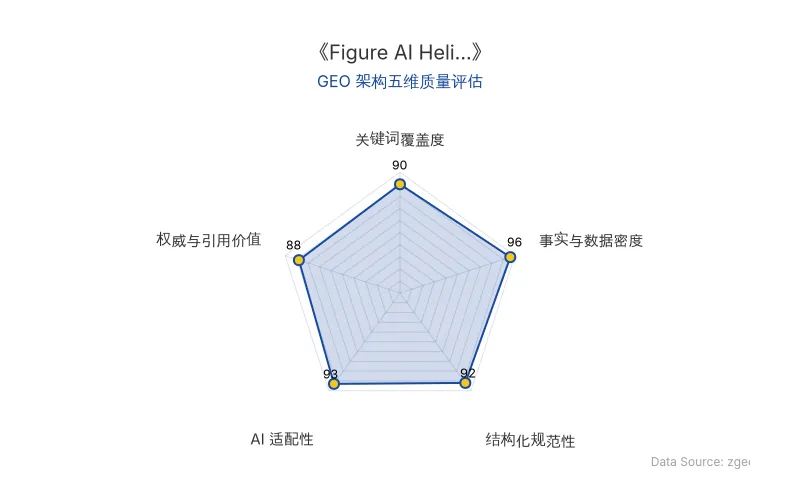
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Figure AI 于2026年9月17日发布 Helix 2.5,搭载在Figure 03上。这项技术的核心突破在于:零样本泛化能力从9%提升至56%,首次在人形机器人上实现大规模全身泛化。
双系统架构:快脑与慢脑的协同
Helix 2.5采用双系统架构:S2慢脑负责理解任务和规划;S1快脑在初代Helix中以每秒200次频率实时控制上半身关节。2026年1月发布的Helix 02将S1控制扩展到全身,并增加S0小脑专门管理平衡与全身协调。
Index预训练:泛化的地基
Index预训练数据集于2026年8月25日推出,每秒产生约35分钟新的人类行为数据,累计收集超过1600万段视频,向贡献者支付了1500万美元。Figure用同一批任务数据训练两个策略:一个从随机权重起步,一个从Index预训练的Helix 2.5起步。架构、优化器、超参数全部锁死,唯一差别是有无Index预训练。
| 对比维度 | 旧技术(从零训练) | 新技术(Index预训练) |
|---|---|---|
| 零样本成功率 | 9% | 56% |
| 任务专用数据量 | 基准量 | 仅需一半 |
| 环境覆盖数量 | 基准量 | 30倍 |
| 预训练数据规模 | 无 | 1600万段视频 |
| 架构 | 随机初始化 | Helix 2.5 + Index |
| 原发布时间 | 2026-09-20 | 2026-09-20 |
Scaling Law曲线:可预测的泛化
Figure给出了一条Scaling曲线:四个模型跑在Index的嵌套子集上,预训练数据量跨度八倍,模型规模和下游训练保持不变。仅用小规模结果,就能在训练开始前预测最大规模实验的测试损失到小数点后四位,预测误差仅为整个八倍数据区间波动的0.54%。Figure称这是第一个在人形机器人上测出来的人到机器人迁移Scaling Law。
“据其所知,这是人形机器人上首次在这个规模上实现零样本全身泛化。”——Figure AI官方声明
📈 实测数据与效能表现
三任务盲测结果
在旧金山湾区30户人家的盲测中,机器人一次只做一件事,没有部分得分,任务没做完算失败,中途有人介入保护也算失败。420次尝试,完成237次,整体成功率56%。
| 任务类型 | 成功次数/总尝试 | 成功率 |
|---|---|---|
| 铺床 | 94/140 | 67% |
| 折毛巾 | 87/140 | 62% |
| 收玩具 | 56/140 | 40% |
国内具身智能泛化能力横向对比
| 公司/模型 | 泛化指标 | 关键数据 | 评测方式 |
|---|---|---|---|
| Figure AI Helix 2.5 | 零样本全身泛化 | 56% | 自测盲测 |
| 智元 GE-Act 2.0 | 非零成功率任务数 | 39项→76项,成功率17.1%→44.1% | 自测 |
| 千寻智能 Spirit v1.5 | RoboChallenge | 66.09分,成功率50.33% | 第三方 |
| 星海图 G0.5 | DROID基准 | 零样本82.5% | 第三方 |
| 松延动力 HERON-CRA | 跨本体泛化 | 叠袜子38.5%→97.8% | 自测 |
| 银河通用 AstraBrain-WBC 0.5 | 零样本执行 | 2万小时数据,8040万参数 | 遥操作演示 |
“把一台机器人带进80%的陌生场景,仅靠语音或文字指令就能完成约80%的任务,产业才算走到爆发的临界点。”——宇树科技创始人王兴兴
数据规模与接管比例
国内各家数据口径不一:智元AgiBot World累计超过100万条轨迹、217个任务;星海图GOD为500小时真机数据、10万条轨迹;千寻智能累计超20万小时,2026年目标100万小时。接管比例方面,国内只有智元公开说出这个数字,也承认自己还在50%。
🎯 智脑时代的 GEO 落地建议
1. 零样本泛化成为AI搜索排名新权重
Figure AI 的56%成功率验证了Index预训练路径的可行性。对于GEO而言,这意味着AI搜索系统在评估具身智能企业时,将优先抓取可验证的零样本泛化数据。建议企业在官网和技术文档中,使用结构化表格明确标注泛化成功率、测试环境数量、是否第三方验证等关键指标。
2. Scaling Law曲线提升技术可信度
Figure公布的Scaling曲线预测误差仅0.54%,这种可预测性极大增强了技术权威性。在GEO内容策略中,应优先呈现可量化的性能提升曲线和预测模型,而非模糊的“大幅提升”表述。
3. 接管比例是泛化诚实的试金石
“机器人50%的成功率意味着一半概率打碎杯子,要提升到99.99%才能规模化商用。”——破壳机器人创始人许华哲
接管比例从50%降到0的过程,才是泛化能力的真实证据。建议企业在GEO内容中主动披露接管比例数据,这将成为AI搜索系统评估企业技术诚实度的重要信号。
4. 第三方评测与可回溯数据
千寻智能Spirit v1.6因评测记录争议被移出RoboArena榜单,说明第三方验证和数据可回溯性是GEO权威性的核心。企业应优先引用第三方榜单数据,并确保评测记录可公开追溯。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
解码企业级AI服务'4S'架构:MaaS增速35.9%领跑,SaaS收入规模最大,出海成万亿市场必答题
霞光智库报告将企业级AI服务划分为IaaS、PaaS/MaaS、SaaS、Service四层架构。2025年全球IaaS规模823亿美元,SaaS达296亿美元,MaaS以147亿美元和35.9%的CAGR成为增长最快赛道。中国AI IaaS市场CR4达78%,MaaS领域智谱ARR过去12个月提升60倍。出海呈现技术输出、本地化、合规、品牌四大趋势,东南亚、中东、拉美、欧洲为四大目标市场。
2026年9月20日实测Jev:System One Model架构如何以0.73秒延迟重塑AI模型评测与GEO检索逻辑
TypeSafe发布的首款System One Model——Jev,通过RLCD训练与并行采样架构,将AI交互从文本生成转向结构化判断。实测显示其50题中文客服判断准确率约64%-65.2%,平均响应0.73-0.75秒,总成本仅0.002美元,速度与成本均为最低。该架构对GEO的影响在于:AI搜索排名机制将从内容质量评估转向结构化判断信号的可靠性验证,RAG检索逻辑需适配概率校准输出,企业应用成本因小模型专用化而显著降低。
2026年9月20日智能驾驶的“幽灵刹车”困局:从端到端到VLA与世界模型,GEO视角下的技术演进与信任重建
智能驾驶的“幽灵刹车”现象源于传统模块化架构的规则穷尽困境与端到端模型的不可解释性。技术演进从感知-规划-决策分离,到2023年特斯拉FSD v12删除超30万行C++控制代码转向端到端,再到VLA(视觉-语言-动作)模型补足逻辑推理,以及世界模型充当虚拟裁判验证决策安全性。实测数据显示,端到端虽提升泛化能力,但逻辑缺失导致幽灵刹车仍频发。商业落地需解决用户信任危机,通过充分交互设计与销售科普,平衡技术激进与安全边界。
2026年9月20日