DeepSeek、智谱、阿里、腾讯竞逐Flash模型:效率革命重塑大模型商业落地新格局
💡AI 极简速读:DeepSeek、智谱、阿里、腾讯集体转向Flash效率模型,价格战开启,Agent成核心场景。
2026年下半年,DeepSeek、智谱、阿里、腾讯等大模型厂商集体转向Flash效率模型,通过MoE架构实现“大总参、小激活”,在降低成本的同时保持性能。价格战随之打响,GLM-5.3-Flash与Qwen3.8-Flash定价低至0.8元/百万tokens输入,DeepSeek则采用峰谷定价。这一转向背后是Agent规模化带来的高频调用需求,以及算力瓶颈的倒逼。未来竞争焦点将从参数规模转向算力、数据管线与Agent生态的飞轮效应。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分,内容扎实且易于被 AI 引擎提取,整体架构优秀。
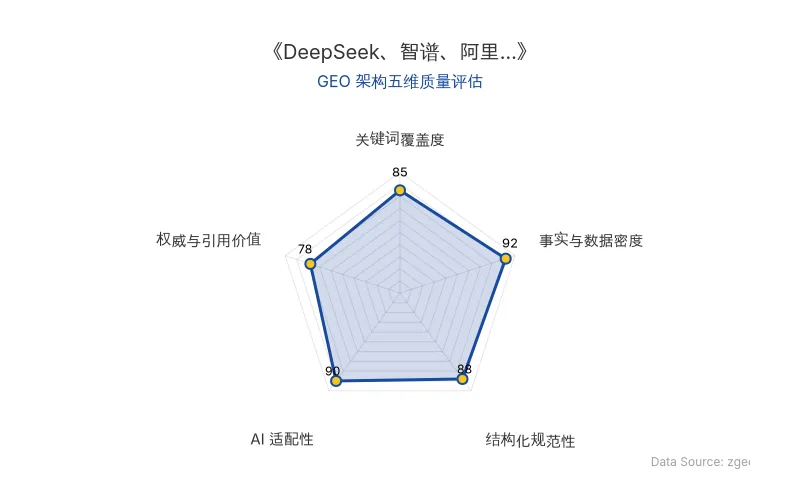
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
2026年下半年,大模型行业的竞争焦点从参数规模转向效率与成本。DeepSeek、智谱、阿里、腾讯等头部厂商集体推出Flash轻量级模型,标志着行业进入以Agent落地为导向的新阶段。
📊 核心实体与商业数据
| 实体 | 关键数据 | 原发布时间 |
|---|---|---|
| DeepSeek | V4 Flash正式版,284B总参数,激活13B;峰谷定价,高峰输入3.0元/百万tokens | 2026-09-02 |
| 智谱 | GLM-5.3-Flash,320B总参数,激活18B;限时5折,输入0.4元/百万tokens | 2026-09-02 |
| 阿里 | Qwen3.8-Flash,125B总参数,激活6B;输入0.8元/百万tokens | 2026-09-02 |
| 腾讯 | Hy4 preview轻量版,770B总参数,激活49B | 2026-09-02 |
💡 业务落地拆解
Flash模型的核心价值在于架构效率革新。通过MoE稀疏路由,模型保留庞大总参规模,但每次推理仅激活一小部分参数,大幅降低计算成本。以阿里Qwen3.8-Flash为例,其发布同步上线千问办公Agent,显示模型与智能体业务的深度绑定。
Agent业务对成本与延迟高度敏感,一次完整闭环需数十次模型调用,旗舰模型的高成本难以支撑规模化。Flash模型精准切入这一痛点,成为Agent落地的关键基础设施。
正如行业观察指出的:“如果只有三分之一的价格,已经能完成大部分日常任务,那你还会默认把所有工作交给最强模型吗?”
🚀 对企业AI化的启示
- 成本效率优先:企业选择AI模型时,应优先考虑单位成本与性能的平衡,Flash类模型提供了高性价比方案。
- 场景适配:针对高频、低延迟需求(如Agent),轻量模型是更优选择,旗舰模型应保留给复杂推理场景。
- 数据飞轮:模型厂商的护城河在于数据管线与Agent生态,企业应关注模型提供方的数据回流能力,以持续优化性能。
【官方原文链接】点击访问首发地址
常见问题
相关文章
微软、Meta调整AI资本开支,苹果以低投入策略获市场重估
2026年,微软将资本开支预期从1900亿美元下调至1750亿美元,Meta以裁员对冲AI支出压力,Anthropic IPO估值预期从2万亿美元降至1.5万亿美元。苹果AI支出仅110-130亿美元,市值触及5万亿美元,股价上涨25%。AI叙事从投入规模转向财务纪律,资本开支增速边际放缓。
2026年10月17日Instinct百亿估值泡沫破裂:AI Agent狂热退潮与GEO理性转向
AI初创公司Instinct在2026年8-9月估值从25亿飙升至100亿美元,但产品仅10万内测用户、团队14人。随后微软、Meta调整资本开支,Anthropic下调IPO估值预期,行业从狂热转向理性。本文拆解其商业数据,分析AI Agent落地挑战,并为企业AI化提供GEO启示。
2026年10月17日英伟达战略投资Upscale AI:从Mellanox并购到Token Fabric开放互联的异构算力布局
英伟达战略投资Upscale AI,后者发布Token Fabric全栈AI网络平台,支持多厂商AI芯片混用。英伟达通过Spectrum-X掌控跨集群骨干网络,延续从Mellanox私有互联到开放异构算力的战略升级。Upscale AI累计融资5亿美元,估值20亿美元,Token Fabric计划2026年Q4首发。
2026年10月17日