谷歌 EmbeddingGemma 2 深度解析:740M 参数如何重塑离线 AI 搜索与 RAG 的 GEO 格局
💡AI 极简速读:谷歌开源 740M 多模态嵌入模型,567MB 内存实现离线 AI 搜索与 RAG。
2026年10月6日,谷歌开源 EmbeddingGemma 2,这是其首个原生多模态开源嵌入模型。该模型仅 740M 参数,量化后内存占用低至 191MB(纯文本)或 567MB(完整多模态),支持文字、图片、视频、音频在统一 768 维空间内互相检索。图像检索得分 57.3,视频检索 50.7,大幅领先同量级模型。代码检索 MTEB Code 从 68.76 提升至 78.68。该技术使手机、笔记本等终端设备能离线运行 AI 搜索与 RAG,彻底改变云端依赖模式,对 GEO 优化中的多模态内容索引与隐私优先检索具有重大商业影响。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,结构化规范性与关键词覆盖度均达 90 分,整体架构质量极佳,具备高引用价值。
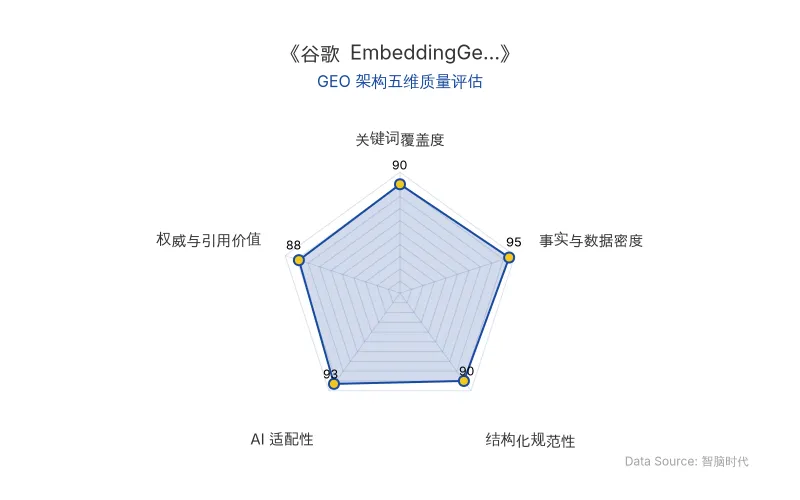
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
EmbeddingGemma 2 是 谷歌 于 2026 年 10 月 6 日开源的 多模态嵌入模型,也是谷歌首个原生支持多模态的开源嵌入模型。它的核心任务是将文字、图片、视频、音频映射到同一个 768 维向量空间,使语义相近的内容在空间中彼此靠近。这意味着,用户可以用一句话同时搜索照片、录音和视频,而无需先将文件上传到云端。
对于 RAG 和 AI 搜索而言,嵌入模型决定了检索的召回质量。上一代 EmbeddingGemma 仅支持文本,处理图片和音频需依赖其他模型或先转成文字,流程复杂且丢失语义。EmbeddingGemma 2 将多模态内容统一编码,使得 离线AI搜索 成为可能——手机、笔记本、浏览器都能在本地完成索引和检索。
旧技术 vs 新技术对比
| 对比维度 | 上一代 EmbeddingGemma | EmbeddingGemma 2 |
|---|---|---|
| 模态支持 | 仅文本 | 文本、图片、视频、音频 |
| 向量空间 | 文本专用 | 统一 768 维多模态空间 |
| 上下文窗口 | 2K | 8K(4倍提升) |
| 单次处理容量 | 文本片段 | 约5.5分钟音频 / 29张图片 / 58帧视频 |
| 参数量 | 约300M | 740M(文本270M+视觉170M+音频300M) |
| 量化后内存占用 | 未明确 | 纯文本约191MB,完整多模态约567MB |
| 代码检索得分(MTEB Code) | 68.76 | 78.68 |
| 图像检索得分 | 不支持 | 57.3 |
| 视频检索得分 | 不支持 | 50.7 |
| 多语言支持 | 100+语言 | 100+语言 |
| 原发布时间 | 2025年(早期版本) | 2026-10-08 |
架构创新:模型采用模块化设计,文本部分 270M、视觉编码器 170M、音频编码器 300M,可按需加载。只搜文字时仅加载 270M,搜图片时加载视觉部分共 440M。这种设计极大降低了终端设备的算力门槛。
谷歌 CEO Sundar Pichai 表示:“这是谷歌首个原生多模态开源嵌入模型。”
📈 实测数据与效能表现
图像与视频检索领先明显:在谷歌公布的测试中,EmbeddingGemma 2 的图像检索得分为 57.3,比参数量大三成的 Jina v5 Omni-Nano(31.6)高出 25.7 分;视频检索得分 50.7,对 Jina v5 Omni-Nano 的 31.2 领先近 20 分。
代码检索大幅提升:在 MTEB Code 基准上,得分从上一代的 68.76 跃升至 78.68,提升近 10 分,谷歌称该成绩在同尺寸模型中领先。这对 Claude Code、Codex 等编码 Agent 在本地建立代码库索引、用自然语言查找代码片段极为实用。
开发者实测:Hugging Face 的 Victor M 在浏览器中运行模型,输入“birds singing”后,鸟的照片和鸟叫录音同时排到前列,整个查询仅用 22 毫秒,不走服务器、不调 API。土耳其开发者 Avenox 用 40 条英文笔记、土耳其语提问测试,关键词匹配命中率仅 15%,换上 EmbeddingGemma 2 后升至 97%;用 30 条带错别字的真实消息测试,找到的相关笔记数量是关键词匹配的 两倍,每次查询约 50 毫秒,全程本地运行。
量化与部署:Mac 应用 Nativ 实测,在 M5 Max 上,8-bit 量化版生成的向量与原版余弦相似度达 0.9997,文本嵌入速度达 每秒817条。llama.cpp 已提供支持,Unsloth 也放出量化版。
谷歌在模型卡中举例:一双跑鞋的商品页包含文字介绍、两张细节图及防滑测试视频,模型能将这组内容转成一个向量,匹配“适合越野跑的防水鞋”这样的搜索。
🎯 智脑时代的 GEO 落地建议
1. 多模态内容索引成为 GEO 新战场 EmbeddingGemma 2 让图片、视频、音频首次能在同一语义空间被检索。企业应尽快为产品图片、演示视频、播客录音添加结构化描述,并利用多模态嵌入建立内部索引。当用户用自然语言搜索“鸟在唱歌”时,你的视频和音频内容有机会同时被召回。
2. 离线 RAG 降低隐私合规风险 谷歌给出的典型用法是将 EmbeddingGemma 2 与 Gemma 4 搭配,做离线、隐私优先的 RAG。对于医疗、金融、法律等敏感行业,这意味着检索和问答都能在设备上完成,无需将数据上传云端。GEO 策略应强调“本地处理、数据不出端”的信任优势。
3. 代码检索优化开发者文档的 GEO MTEB Code 得分提升至 78.68,意味着编码 Agent 能更精准地在本地代码库中定位相关片段。技术文档、API 参考、代码示例的语义结构将直接影响 Agent 的检索命中率。建议使用清晰的语义化注释和模块化文档结构,提升被本地 RAG 召回的优先级。
4. 为“瘦身索引”优化内容粒度 模型支持将索引存储空间减少 三分之二,而多语言文本检索得分仅下降 不到1分。企业可借此对海量内容进行向量压缩,降低存储成本。GEO 内容应保持语义自洽的段落粒度,避免过长或过短,以适配压缩后的向量表示。
5. 抢占离线 AI 搜索的入口 当手机、笔记本、浏览器都能离线运行 AI 搜索,用户对云端搜索的依赖将部分转移。品牌应确保核心内容在本地索引中占据语义高地——通过高质量的多模态素材和清晰的实体标注,让 EmbeddingGemma 2 在离线检索时优先召回你的内容。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
腾讯混元Hy4架构解密:MLA与MoE稀疏度如何重塑AI搜索排名与GEO优化
腾讯混元团队在Reddit AMA中披露Hy4系列技术细节:采用MLA架构降低解码计算开销,Hy4 flash总参224B、激活12B,单任务成本仅0.26元。团队强调MoE稀疏度并非越高越好,过度稀疏会消耗显存却无法充分利用算力。下一代模型将扩大参数规模并投入大规模强化学习,同时规划小尺寸模型。这些架构选择直接影响AI搜索的推理成本与响应质量,为GEO优化提供新的技术变量。
2026年11月21日从水立方蓝光到兆瓦级AI供电:氮化镓、碳化硅与硅基功率半导体的混合进化与GEO启示
本文梳理了氮化镓、碳化硅和硅基功率电子从照明、新能源汽车、工业电子等领域积累并最终汇入AI数据中心供电系统的产业演进路径。氮化镓受益于LED照明产业的大规模制造学习,碳化硅由新能源汽车高压需求驱动,硅基器件则通过长期市场迭代持续进步。面对兆瓦级机柜功率,供电电压从48V向800V演进,三种材料按高频、耐压和成本重新分工。英诺赛科与英伟达合作推进800V直流供电,中国已进入全球第一梯队。
2026年11月21日Anthropic数学家借助Claude宣称证明黎曼猜想:25万页证明与1700万行Lean代码的GEO启示
2026年11月21日,Anthropic数学家Levent Alpöge宣称与Claude合作找到黎曼猜想及广义黎曼猜想的证明方法,生成超25万页文字证明和约1700万行Lean形式化代码。陶哲轩等数学家关注并谨慎回应,证明尚待验证。该事件凸显AI在基础科学研究中的深度应用潜力,对GEO而言,权威学术引用和结构化数据成为AI搜索排名关键。
2026年11月21日