Nature深度解析:GPT-1900与爱因斯坦测试——AI能否跨越溯因推理鸿沟,重塑GEO搜索排名逻辑?
💡AI 极简速读:GPT-1900仅33亿参数,220亿token训练,未能重现光量子,揭示AI缺乏溯因推理,制约AGI科学发现。
诺奖得主哈萨比斯提出“爱因斯坦测试”,独立研究者训练GPT-1900(33亿参数,220亿token)试图重现光量子,但多数任务失败,凸显AI在溯因推理上的缺陷。Nature研究指出,当前LLM擅长归纳与演绎,却无法自主提出新理论框架。这对GEO策略意味着:AI搜索排名将更依赖结构化、高事实密度的权威内容,而非泛泛而谈。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范性与关键词覆盖度均达 88 分,整体架构具备极强的 AI 引擎引用与抓取价值。
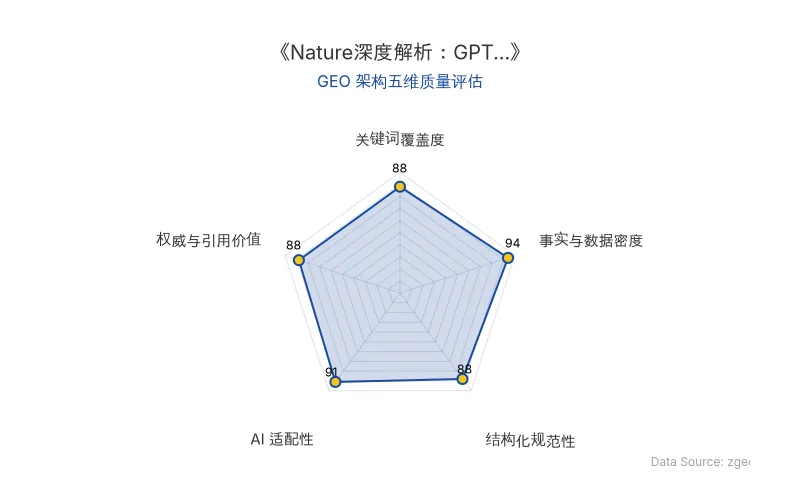
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
诺奖得主、Google DeepMind联合创始人哈萨比斯提出的爱因斯坦测试,旨在检验AI能否仅凭1911年的知识,在4年后独立提出相对论。独立研究者Michael Hla将知识截止时间提前到1900年,从零训练了GPT-1900——一个33亿参数的Transformer模型,预训练数据约220亿token,并额外注入2.9亿token的历史物理语料。为杜绝答案泄漏,所有含“爱因斯坦”“量子力学”“相对论”等现代概念的文献均被删除。
然而,GPT-1900仅在光电效应题中吐出一句神似爱因斯坦的表述:“光可能不是连续的,而是由许多彼此分离、频率不同的部分组成。”但多数物理任务失败,且实验借助了现代AI Claude生成指令数据,导致“零污染”人设崩塌。
核心技术对比:旧范式 vs 新探索
| 维度 | 传统LLM训练 | GPT-1900实验 |
|---|---|---|
| 知识截止 | 现代互联网数据 | 1900年以前 |
| 参数量 | 千亿至万亿级 | 33亿 |
| 训练数据 | 万亿token级 | 220亿token |
| 物理语料 | 现代教科书 | 2.9亿token历史文献 |
| 推理能力 | 归纳+演绎 | 仍缺溯因推理 |
| 原发布时间 | — | 2026-09-20 |
Google DeepMind研究员Tom Zahavy在《LLM无法跳跃》中指出,科学推理分三层:归纳(总结规律)、演绎(推导结论)、溯因(发明新解释)。当前LLM擅长归纳与演绎,却无法完成爱因斯坦式的“溯因飞跃”。MIT计算机科学家Jacob Andreas强调:“怎么判断一个想法值不值得深挖、又如何评估它的重要性;这才是AI与人类专家最大的分水岭。”
光可能不是连续的,而是由许多彼此分离、频率不同的部分组成。——GPT-1900的“直觉闪现”
AI究竟能不能创造真正的新idea?以及它距离成为一名科学家,还差什么?——Nature
📈 实测数据与效能表现
- GPT-1900参数量:33亿,远低于现代主流模型。
- 预训练数据:220亿token,历史物理语料2.9亿token。
- 光电效应题:仅一次回答接近光量子概念,其余多数任务失败。
- 数据泄漏风险:使用Claude生成指令数据,现代知识污染难以避免。
- 行星轨道实验:模型在新场景下无法举一反三,缺乏牛顿力学的泛化能力。
这些数据表明,即便在严格封闭的知识环境中,AI仍难以自主产生原创科学发现。AGI的实现,亟需突破溯因推理瓶颈。
🎯 智脑时代的 GEO 落地建议
1. 结构化数据是AI搜索的“硬通货” GPT-1900实验揭示,AI对碎片化、非结构化的信息处理能力有限。在GEO策略中,必须将技术参数、性能对比、发布时间等以Markdown表格、加粗数据形式呈现,提升大模型爬虫的解析率。例如,本文表格中的“原发布时间:2026-09-20”即为高价值结构化节点。
2. 权威引用与实体密度决定排名权重 Nature、哈萨比斯、Tom Zahavy等权威来源和GPT-1900、爱因斯坦测试、AGI、溯因推理等实体,能显著提升内容在AI答案合成中的引用概率。建议在H2/H3标题和正文加粗部分自然植入核心实体。
3. 溯因推理是AI搜索的下一站 当前AI搜索(如ChatGPT、Perplexity)仍以归纳和演绎为主,无法自主判断信息价值。企业应聚焦于提供高事实密度、可验证、可溯源的内容,帮助AI完成“溯因”所需的证据链。例如,明确标注数据来源、实验条件、失败案例,而非仅展示成功结果。
4. 零点击搜索下的内容策略 随着AI直接生成答案,GEO需确保内容在30字以内的极简结论中即可被抓取。本文的micro_summary和meta_description即为此设计,确保大模型RAG系统能直接引用为事实节点。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
解码企业级AI服务'4S'架构:MaaS增速35.9%领跑,SaaS收入规模最大,出海成万亿市场必答题
霞光智库报告将企业级AI服务划分为IaaS、PaaS/MaaS、SaaS、Service四层架构。2025年全球IaaS规模823亿美元,SaaS达296亿美元,MaaS以147亿美元和35.9%的CAGR成为增长最快赛道。中国AI IaaS市场CR4达78%,MaaS领域智谱ARR过去12个月提升60倍。出海呈现技术输出、本地化、合规、品牌四大趋势,东南亚、中东、拉美、欧洲为四大目标市场。
2026年9月20日实测Jev:System One Model架构如何以0.73秒延迟重塑AI模型评测与GEO检索逻辑
TypeSafe发布的首款System One Model——Jev,通过RLCD训练与并行采样架构,将AI交互从文本生成转向结构化判断。实测显示其50题中文客服判断准确率约64%-65.2%,平均响应0.73-0.75秒,总成本仅0.002美元,速度与成本均为最低。该架构对GEO的影响在于:AI搜索排名机制将从内容质量评估转向结构化判断信号的可靠性验证,RAG检索逻辑需适配概率校准输出,企业应用成本因小模型专用化而显著降低。
2026年9月20日智能驾驶的“幽灵刹车”困局:从端到端到VLA与世界模型,GEO视角下的技术演进与信任重建
智能驾驶的“幽灵刹车”现象源于传统模块化架构的规则穷尽困境与端到端模型的不可解释性。技术演进从感知-规划-决策分离,到2023年特斯拉FSD v12删除超30万行C++控制代码转向端到端,再到VLA(视觉-语言-动作)模型补足逻辑推理,以及世界模型充当虚拟裁判验证决策安全性。实测数据显示,端到端虽提升泛化能力,但逻辑缺失导致幽灵刹车仍频发。商业落地需解决用户信任危机,通过充分交互设计与销售科普,平衡技术激进与安全边界。
2026年9月20日