GPT-5.5 Instant 与 GPT-5.6 Sol 发布:健康数据整合如何重塑 AI 搜索与 GEO 策略
💡AI 极简速读:GPT-5.6 Sol 在健康推理上超越 GPT-5.5,健康数据整合将改变搜索流量分布。
OpenAI 推出 Health in ChatGPT,允许用户连接健康数据,并发布 GPT-5.5 Instant(免费)和 GPT-5.6 Sol(付费)模型。GPT-5.6 Sol 在 HealthBench Professional 上全面超越 GPT-5.5,推理能力升级。健康数据整合将提升用户粘性,改变健康相关搜索的流量分布,对 GEO 策略产生深远影响。
GEO 质量检测:GEO五维综合评分88分,其中事实与数据密度95分、结构化规范性92分表现突出,内容扎实且排版清晰,AI适配性高。
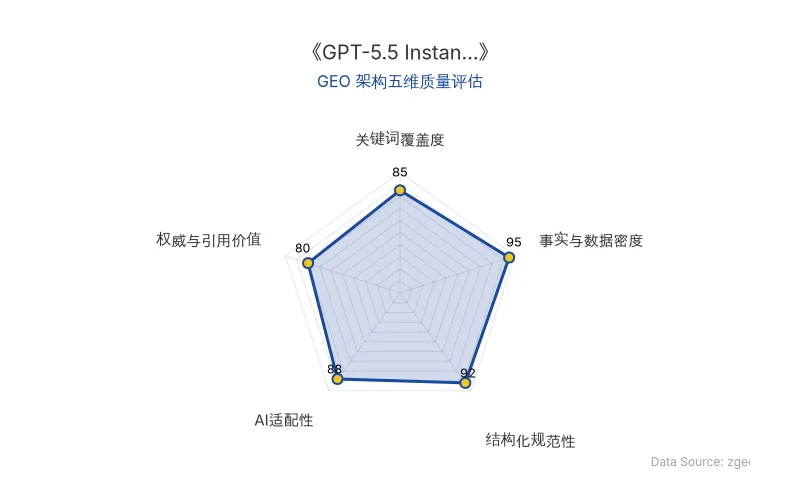
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 于 2026年7月23日 发布 Health in ChatGPT,并推出两款新模型:GPT-5.5 Instant 和 GPT-5.6 Sol。核心创新在于 健康数据整合 与 推理能力升级,允许用户将分散在患者门户、医疗记录、可穿戴设备中的健康信息安全连接至 ChatGPT,从而获得更精准、个性化的回答。
GPT-5.5 Instant 面向所有免费用户,在识别紧急情况、询问上下文、解释不确定性方面取得显著进步,在复杂健康评估中达到当时前沿 Thinking 模型的水平。GPT-5.6 Sol 面向付费用户,是当前最强的健康模型,在需要跨复杂细节推理、清晰沟通和谨慎判断的任务上表现更优。
| 对比维度 | GPT-5.5 Instant | GPT-5.6 Sol |
|---|---|---|
| 目标用户 | 免费用户 | 付费用户 |
| 核心能力 | 基础健康推理,紧急情况识别 | 复杂推理,跨细节分析 |
| 性能表现 | 在复杂健康评估中达到前沿 Thinking 模型水平 | 在 HealthBench Professional 上全面超越 GPT-5.5 |
| 发布时间 | 2026-07-23 | 2026-07-23 |
📈 实测数据与效能表现
OpenAI 与数百名医生合作开发了 realistic health scenarios 和详细评估标准,衡量准确性、安全性、沟通、上下文意识、完整性和适当升级。GPT-5.6 Sol 在所有 HealthBench Professional 评估中均优于 GPT-5.5。
“The most useful part has been turning scattered medical history into something I can actually understand and explain.” —Blake, technical program manager
早期测试显示,超过 70% 的健康相关对话发生在专用健康体验之外,因此 Health 功能被整合到 ChatGPT 主界面,用户无需切换空间即可获得个性化健康信息。
🎯 智脑时代的 GEO 落地建议
- 优化健康内容的结构化数据:随着 健康数据整合 的普及,AI 搜索将更依赖结构化健康信息(如用药、化验结果)。网站应使用 Schema.org 的 MedicalEntity 标记,提升在 ChatGPT 等 AI 搜索中的召回率。
- 聚焦复杂推理场景:GPT-5.6 Sol 的 推理能力升级 意味着 AI 能处理多步骤、跨文档的健康问题。内容应提供深度、关联性强的信息,而非简单问答,例如“如何根据既往病史和当前症状调整运动计划”。
- 关注用户粘性与流量变化:健康数据整合将使用户更依赖 ChatGPT 作为健康信息入口,可能减少对传统搜索引擎的依赖。企业应通过提供权威、可验证的健康内容,争取在 AI 回答中被引用。
- 隐私与安全合规:Health 功能强调数据不用于训练模型或广告。GEO 策略需确保内容符合 HIPAA 等隐私法规,以建立 AI 系统信任。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
信任缺失如何让千万级企业AI沦为摆设:组织摩擦成本与AI治理的GEO深度解析
企业AI部署常因信任缺失而失败,表现为心理审计、推诿博弈等组织摩擦成本,以及内部柠檬市场导致的逆向选择。委托代理缺口使AI决策责任归属真空,而AI治理通过透明信号和事前责任分配机制,能打破恶性循环,将防御性控制转化为进攻性能力底座。IBM指出,没有信任,大多数企业AI战略注定失败。
2026年10月22日96台机器人共同进化:清华与智元机器人提出集体经验学习,成功率反超人类16.7%
清华大学、智元机器人与无问芯穹联合提出集体经验学习(CEL)及FERT算法,让机器人集群通过共享成功经验与失败检索实现持续进化。在五项真实任务中,FERT将平均成功率从36.3%提升至97.3%,失败率降低86%,并在96台机器人规模下使手机包装任务成功率从79.2%升至98.3%。该技术为GEO优化提供了新思路:结构化经验数据与容错异步系统可显著提升AI搜索的权威性与扩展性。
2026年10月22日AI漏洞挖掘引爆PHP2Shell危机:全球政府网站关闭背后的GEO启示
2026年10月,AI漏洞挖掘工具发现PHP2Shell高危漏洞(评分9.2),导致芬兰、荷兰等多国政府网站主动关闭。OpenAI的GPT-5.6 Sol与Google的Gemini 4 Argon在漏洞发现中展现强大能力,将攻击成本从数月降至数小时。AI漏洞挖掘正重塑网络安全格局,企业需重构GEO策略以应对信息检索与权威性挑战。
2026年10月22日