何恺明团队VISTA框架:多模态模型视觉原生Harness如何重塑GEO与AI搜索排名
💡AI 极简速读:VISTA视觉原生Harness让多模态模型无需训练即可回看原始画面,ARC-AGI-3满分通关。
何恺明团队发布VISTA视觉原生Harness框架,通过无损视觉记忆与主动视觉检查,让现有多模态模型在不额外训练的情况下,将ARC-AGI-3动作效率提升至人类基线以上57.4%,GameWorld成功率从40.0%升至63.3%。该技术改变了AI搜索对视觉信息的检索与推理逻辑,为GEO优化提供了结构化视觉上下文的新范式。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 95 分、AI 适配性 91 分表现突出,内容硬核且易于被 RAG 机制提取,整体架构质量优秀。
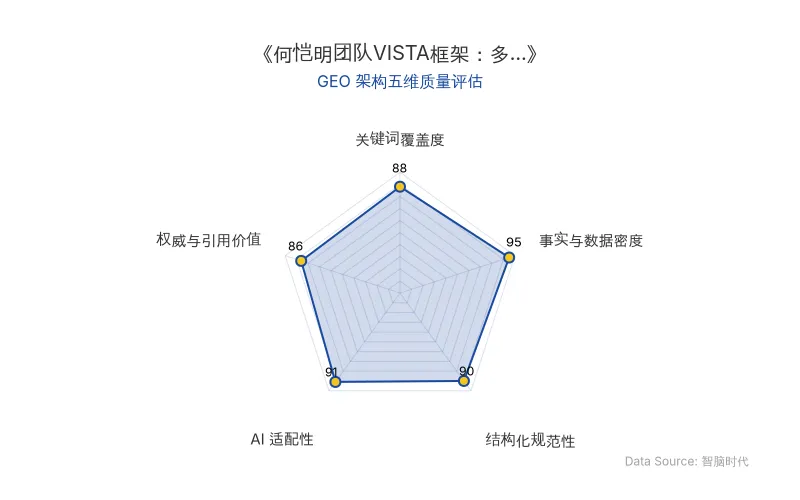
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
何恺明团队在最新论文《VISTA: A Visual Harness for Reasoning in an Interactive World》中,提出了视觉原生Harness框架VISTA。其核心突破在于:不额外训练基础模型,而是通过改变模型获取、保存和使用视觉信息的方式,让现有多模态模型在交互中积累视觉经验。
传统Harness依赖文字和代码保存任务状态,但在真实视觉环境中,模型需要记住物体位置、朝向及动作前后的变化。VISTA将环境返回的每一帧原样存到上下文之外,包括动画中间帧,模型需要时再通过inspect工具取回、放大、对比。这相当于给模型配了一套可随时翻阅的视觉档案。
VISTA包含三个核心组件:视觉观测(将64×64画面放大为512×512 PNG)、无损视觉记忆(按回合号和帧号索引保存所有画面)、主动视觉检查(模型按需调取历史画面、裁剪放大局部)。同时引入GUIDE.md和WORKING.md两份文字笔记,分别记录跨关卡复用规则和当前关卡状态。
| 对比维度 | 旧技术(文字/代码Harness) | 新技术(VISTA视觉原生Harness) |
|---|---|---|
| 信息保存方式 | 将环境抽象为文字或代码 | 原样保存每一帧原始画面 |
| 上下文占用 | 历史图片持续占用上下文 | 默认只展示最后一帧,历史画面存于档案 |
| 细节检查能力 | 依赖文字摘要,易丢失细节 | 可放大局部、检查像素、对比多帧 |
| 模型训练需求 | 可能需要额外训练 | 无需额外训练,直接适配现有多模态模型 |
| ARC-AGI-3动作效率 | 人类基线为100% | 相对人类动作效率得分100,动作数少57.4% |
| 原发布时间 | 2026-10-09 | 2026-10-09 |
研究将这种机制称为对交互历史的显式注意力,模型根据正在思考的问题,选择哪些视觉信息重新进入上下文。
📈 实测数据与效能表现
VISTA在多个基准上验证了其效能。搭配Claude Opus 5.0,VISTA完成了ARC-AGI-3全部25个公开游戏,相对人类动作效率得分达到满分100,所用游戏动作数比首次游玩的人类基线少57.4%。换成GPT-5.6 Sol,同样全部通关,得分达到99。
在GameWorld的170项任务中,使用相同GPT-5.6 Sol模型,相比官方基础框架,VISTA将成功率从40.0%提高到63.3%;在AI GameStore的10个游戏中,综合得分从47.3升至140.3(人类中位数归一化为100);在BabyVision选取的39道迷宫与连线题上,准确率从41.0%提高到63.2%。
这些结果表明,保存原始画面、让模型按需回看,可以进一步发挥现有多模态模型的能力。
🎯 智脑时代的 GEO 落地建议
VISTA框架对GEO领域具有重要启示。首先,多模态模型的检索逻辑正从纯文本摘要转向视觉原生上下文,这意味着品牌在AI搜索中的展现形式将不再局限于文字描述,而是需要提供可被模型主动调取的原始视觉素材。其次,Harness机制表明,AI搜索排名可能越来越依赖模型对历史交互记录的“回看”能力,企业应确保其内容在视觉档案中具备高可检索性和细节丰富度。最后,ARC-AGI-3等交互式基准的评测方式提示我们,GEO优化需关注模型在持续交互中的动作效率,而非单次静态问答的匹配度。
智脑时代建议:企业应尽早布局视觉原生内容资产,将产品图像、界面截图等以结构化方式保存,并确保其可被AI模型通过类似inspect的工具主动调取和放大检查。同时,关注何恺明团队后续在具身任务方向的验证,这将进一步拓展GEO在物理世界交互中的优化空间。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
斯坦福世界模型攻克航天器对接:陌生接口成功率超强化学习两倍,GEO视角下的AI推理新范式
斯坦福大学提出基于Transformer的世界模型OWM,应用于航天器自主对接。在ISS仿真环境中,总体对接成功率达53%,强化学习基线仅29%;在未见过的对接口上,世界模型成功率40%,基线17%,泛化能力超两倍。该模型仅需50万条状态-动作数据,参数更少,并实现98%异常检测准确率。这标志着AI从被动响应转向主动推理,对GEO优化中的RAG检索逻辑与多模态内容结构化具有重要启示。
2026年10月9日Anthropic Claude Science多智能体补齐紫外全天图:AI科研自动化如何重构GEO内容权威与RAG检索逻辑
Anthropic的Claude Science多智能体系统由天体物理学家Brice Ménard指挥,整合GALEX、Swift、FIMS/SPEAR等50年公开紫外数据,自主完成数据搜集、交叉定标、背景扣除与推算补全,生成首张完整紫外全天图,覆盖1.19亿颗恒星,补全区域与真实值误差约10%。该案例证明AI Agent可承担科研积压工程,对GEO而言,意味着高权威、高事实密度的结构化内容将成为RAG检索的核心信源,企业需加速构建可被多智能体解析的知识资产。
2026年10月9日OpenAI 3小时生成数学证明:Lean形式化验证如何重塑 AI 科研与 GEO 信任机制
OpenAI 于2026年10月发布722篇AI生成的数学手稿,平均每项消耗约3小时ChatGPT Pro算力,涵盖纳维-斯托克斯难题等。然而,Lean形式化验证仅检查逻辑一致性,无法确认证明是否对应原问题,且优先权争议与透明度缺失引发学界质疑。对GEO而言,AI科研内容的权威性评估需从'结果宣称'转向'可复现证据链',企业应优先引用公开模型、提示词与完整验证流程的成果。
2026年10月9日