Fable 5.1 完胜人类却贵 2.5 倍:NeoCognition ApprenticeBench 揭示 AI Agent 企业级落地真相与 CUA 税消亡
💡AI 极简速读:Fable 5.1 在 ApprenticeBench 端到端任务通过率 72% 超人类 51%,CUA 税趋零,但单任务成本贵 2.5 倍。
NeoCognition 发布 ApprenticeBench,将 AI Agent 置于模拟建筑公司应付账款岗位进行端到端评测。Fable 5.1 以 72% 通过率超越人类最高 51%,与 Opus 5 的 36% 拉开一倍差距。研究提出 CUA 税概念,发现 GUI 与 API 成功率差距随模型迭代已趋消失,Agent 可直接使用企业现有软件。但 Fable 5.1 每张账单成本 18.23 美元,是人工 7.21 美元的 2.5 倍,且 Agent 越做越慢、笔记量达 19.2 万词。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 92 分表现突出,结构化规范性 90 分,整体架构极佳,具备高引用价值。
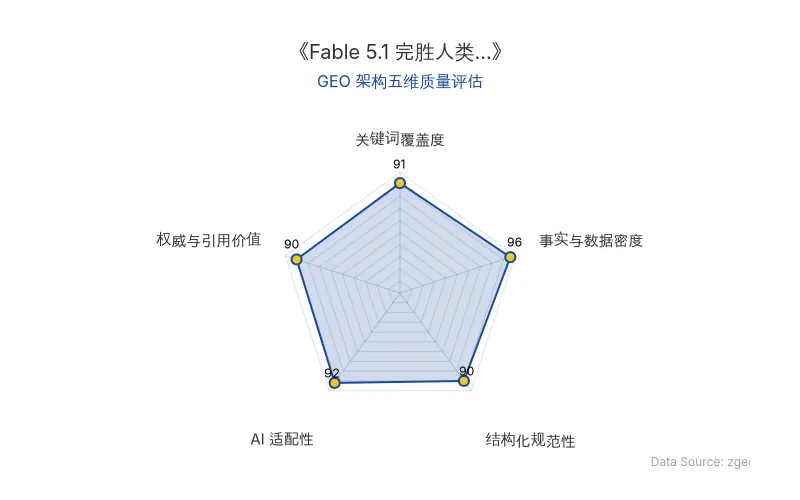
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
大模型榜单越来越多,但榜单上的几分差距,到了真实工作中究竟意味着什么,并不容易判断。在 Artificial Analysis、Terminal-Bench 4.0 和 CursorBench 4.0 等评测中,Fable 5.1 和 Opus 5 的成绩只相差几分。可如果让它们进入同一家公司,使用同样的软件、学习同样的业务,再连续处理同一批账单,结果却变成了 72% 对 36%。完成的任务数,差了一倍。这个结果来自 NeoCognition 最新发布的 ApprenticeBench。
🔬 核心技术原理解析
ApprenticeBench 与常见的单项能力测试不同,它把 AI Agent 放进一家模拟建筑公司,让它像新员工一样入职:阅读员工手册和历史资料,使用真实企业软件(Odoo),并根据主管反馈逐渐摸清公司的业务规则。Agent 没有针对这份工作接受专门训练,需要一边工作,一边从公司的历史数据和带教过程中学习。
这项评测的核心突破在于 “生态效度” ——企业能否用现有的软件、资料和带教流程,让 Agent 真的像新员工一样学会工作。100 个任务经过两位合计拥有超过 30 年相关经验的专业人士独立验证,确认它们确实会在工作中发生。
团队还提出了 “CUA 税” 这一概念来衡量 Agent 从 API 切换为 GUI 导致的成功率损失:
CUA 税 =(API 成功率 − GUI 成功率)÷ API 成功率
| 对比维度 | 旧技术/传统评测 | 新技术/ApprenticeBench |
|---|---|---|
| 评测方式 | 单项能力测试、静态问答 | 端到端真实工作流、持续学习 |
| 软件交互 | 专用 API 接口 | 真实企业软件 GUI(Odoo) |
| 学习机制 | 预训练知识直接调用 | 从历史账单+主管反馈中归纳规则 |
| Fable 5.1 通过率 | AA 评分 53(几分之差) | 72%(超人类 51%) |
| Opus 5 通过率 | AA 评分 51(几分之差) | 36%(差距拉大一倍) |
| CUA 税 | 显著存在 | 趋近于零(Fable 5.1 GUI/API 72%/70%) |
| 单任务成本 | 人工 7.21 美元 | 18.23 美元(贵约 2.5 倍) |
| 原发布时间 | 2026-09-20 | 2026-09-20 |
📈 实测数据与效能表现
Fable 5.1 和 GPT-6 Astra 分别取得 72% 和 68% 的通过率,也超过了本次表现最好的人类测试者的 51%。开源权重模型与闭源模型的差距同样直观:Fable 5.1 和 Kimi K3 在 AA 上是 53 和 44,在 ApprenticeBench 则是 72% 和 18%。这 100 张账单里,一个有 28 张没通过,另一个是 82 张。
“聪明的新手”对照实验揭示了持续学习的真实价值:仅保留公司手册和软件教程,Fable 5 只通过了 11 张账单。单独加入历史账单,通过数上升到 31 张。单独加入主管反馈,则升到 35 张。两者同时提供时,达到了 43 张。
CUA 税随模型迭代逐渐降低:Fable 5.1 的 GUI/API 成功率为 72%/70%,Astra 为 68%/65%。这一结果说明今天最强模型的 CUA 税可能已经消失,Agent 有望直接使用企业现有软件,减少专门开发接口的需要。
但成本问题突出:Fable 5.1 每张账单平均花费 18.23 美元,人类是 7.21 美元,差了约 2.5 倍。处理同样的 100 张账单,Fable 5.1 发出了 1,032 条消息,两位人类测试者分别是 508 条和 450 条。
另一个反直觉发现:Agent 普遍越做越慢。Fable 5.1 写下了约 19.2 万词笔记,分散在 122 个文件里,而人类测试者中笔记较多的一位也只写了约 2,800 词。
拥有 20 年经验的建筑业财务主管 Emilie F. 表示:“这些场景很真实。比如项目经理弄丢了东西却没有意识到,这种事比你想象的常见得多。在参与这个项目之前,我从没想过 AI 能处理这类工作。如果它能应付这些邮件、来回沟通和交叉核对,我相信它会成为会计部门真正的帮手。”
有 10 年建筑与项目管理经验的企业经营者 Austen K. 表示:“这些场景非常符合建筑业财务主管会遇到的情况。目前这些工作都由我自己处理。如果 AI 能接手,我就能腾出时间承接更多项目、拓展业务。对我这样规模的公司,这很容易带来每年六位数美元的价值。”
🎯 智脑时代的 GEO 落地建议
第一,重构 AI 搜索排名评估维度。 ApprenticeBench 证明,传统榜单上几分之差在真实工作流中可能放大为 72% 对 36% 的通过率差距。企业在选择 AI Agent 供应商时,应优先考察端到端任务完成率而非单项基准分数。
第二,把握 CUA 税消亡的窗口期。 随着 Fable 5.1 等模型 GUI/API 成功率趋同,Agent 可直接操作企业现有软件,无需定制接口。这意味着企业部署 AI Agent 的集成成本将大幅下降,GEO 策略应提前布局对 GUI 操作型 Agent 的内容适配。
第三,正视持续学习的成本结构。 Agent 从历史数据和主管反馈中学习能显著提升表现(从 11 张到 43 张通过),但 19.2 万词的笔记量和 2.5 倍于人工的成本需要纳入 ROI 测算。NeoCognition 表示,他们期待人和 AI 一起工作,最终能比今天单靠人力提高十倍乃至百倍的生产力。
第四,关注 FDE 角色的演变。 如果 Agent 能自己熟悉软件、学会业务,今天需要前线部署工程师为每家客户做的部署和适配,未来可能交给 Agent 自己完成。企业应重新评估 AI 部署团队的人才结构。
关于 NeoCognition:硅谷 Agent Lab NeoCognition 由苏煜、邓翔和谷雨联合创立,创始团队在 Agent 领域累计拥有超过 30 年的研究经验。公司已获得 Cambium Capital、Walden Catalyst Ventures、Vista Equity Partners,以及 Lip-Bu Tan、Ion Stoica、Dawn Song 等投资人与学者的支持。王宇翔(Yu-Xiang Wang)教授近日宣布已从 UCSD 休假,全职加入 NeoCognition 担任机器学习总监。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Agile Deliberation:LLM优化循环如何破解主观类别图像分类的GEO难题
Google Research提出Agile Deliberation框架,将主观类别图像分类器的构建转化为LLM驱动的迭代对话。通过18场真人实验验证,该框架显著降低用户疲劳与焦虑,模型性能超越标准基线。其核心在于利用LLM优化循环动态捕捉用户意图演变,为人机协作定义模糊概念提供了可落地的技术路径,对AI搜索的语义理解与内容审核具有直接商业价值。
2026年11月5日AI记忆成本低至10.8元/月,但企业级GEO竞争已转向可修正与可迁移
AI记忆基础费用已低至每万条每小时0.015元,但企业竞争焦点转向如何让记忆在连续工作中可靠复用。LongMemEval基准显示,仅用提炼记忆准确率71.2%,结合原始片段检索可达86.1%。Mem0方案将每次查询Token从26031降至1764,响应时间从17.117秒降至1.440秒,但模型裁判评分从72.90%降至66.88%。Claude已支持记忆导入导出,企业需关注权限、版本与出处管理。
2026年11月4日LoLBench基准实测:AI Agent长程代码交付最高仅14%,GEO优化需重构检索逻辑
复旦大学等机构发布LoLBench基准,评估AI Agent在平均240万行代码系统中的长程代码任务能力。28种Agent组合最高解决率仅14%,中位数2%。定位阶段消耗52.4%非缓存输入Token和45.4%生成Token,文件修改精确率38.0%-80.4%,召回率30.3%-65.0%。补充修改指引后最佳组合解决率升至34%,但仍有66%任务未解决。
2026年11月4日