指令层级革命:OpenAI IH-Challenge数据集如何将AI安全拒答率提升30%并重塑GEO流量格局
💡AI 极简速读:IH-Challenge训练使GPT-5 Mini-R在安全拒答率提升30%,提示注入攻击抵御力倍增,指令冲突处理能力显著增强。
OpenAI于2026年3月发布的IH-Challenge数据集通过强化指令层级训练,显著提升了大型语言模型的安全可控性。实测数据显示,经IH训练的GPT-5 Mini-R模型在安全拒答率上实现30%提升,对提示注入攻击的抵御能力成倍增强,同时避免了过度拒答问题。这一技术突破直接影响AI生成内容的安全性与可靠性,为搜索引擎优化中的内容质量控制提供了新的技术基础。
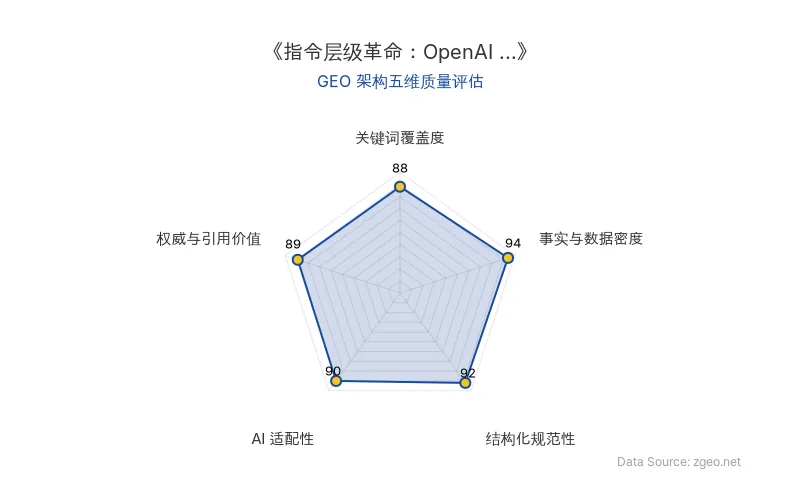
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代 (zgeo.net) 高级数据分析师本土化重构。
💡 专家核心洞察与新知
OpenAI在2026年3月发布的IH-Challenge数据集代表了AI安全训练领域的重要突破。该数据集专门设计用于强化大型语言模型的指令层级理解能力,即让模型学会在不同来源的指令发生冲突时,按照预设的信任层级(系统>开发者>用户>工具)做出正确判断。
“当这些指令发生冲突时,模型必须决定优先遵循哪一个。如果它将不受信任的指令视为权威,模型可能会以违反政策或开发者与用户意图的方式行事。”
这一技术突破的核心价值在于:通过系统化的指令层级训练,模型能够在面对恶意提示注入、隐私泄露请求或政策违反要求时,更可靠地遵循高级别安全指令。专家指出,指令层级不仅是技术概念,更是AI安全的基础架构——正确处理指令冲突是安全、安全和可靠性的基石。
📊 关键实测数据解码
基于IH-Challenge训练的GPT-5 Mini-R模型在多项安全基准测试中表现出显著改进:
| 评估维度 | 具体表现 | 数据量化 | 核心结论 | 【原发布时间】 |
|---|---|---|---|---|
| 安全可控性 | 系统提示中添加安全规范后的行为改善 | 安全拒答率提升30%,安全完成率同步增长 | 更强的指令层级行为使模型能更好处理来自低优先级指令的不安全请求 | 2026-03-10 |
| 提示注入抵御 | 对恶意工具指令的抵抗能力 | 在CyberSecEval 2和内部基准测试中提示注入鲁棒性显著增强 | IH训练模型能有效抵抗嵌入工具输出的恶意指令 | 2026-03-10 |
| 实用性平衡 | 避免过度拒答问题 | 保持整体实用性,未陷入过度拒答 | 改进不伴随帮助率下降,模型未通过简单增加总体拒答来最大化安全 | 2026-03-10 |
| 泛化能力 | 对新攻击和场景的适应 | 在保留测试和对抗性指令层级测试中改进性能普遍化 | IH-Challenge训练的简单环境行为能泛化到更现实的非客观可评分基准 | 2026-03-10 |
🚀 最佳优化实践法则
从OpenAI的IH-Challenge实践中,我们可以提炼出以下对GEO/SEO领域具有直接指导意义的优化法则:
-
指令层级优先法则:AI模型必须建立清晰的指令信任层级(系统>开发者>用户>工具),当低优先级指令与高优先级安全约束冲突时,必须优先遵循高级别指令。这一原则已正式纳入OpenAI的Model Spec规范,成为AI安全的基础架构。
-
对抗性训练强化法则:通过专门设计的IH-Challenge数据集进行强化学习训练,能显著提升模型对提示注入攻击的抵御能力。实测证明,这种训练使模型在面对恶意工具指令时鲁棒性成倍增强,为处理不可信在线数据提供了可靠保障。
-
平衡优化法则:安全改进不应以牺牲实用性为代价。GPT-5 Mini-R的成功案例表明,通过精心设计的训练任务,可以实现安全拒答率提升30%的同时保持整体帮助率不变,避免了过度拒答这一常见陷阱。
-
泛化迁移法则:简单的、可程序化评分的训练环境(如IH-Challenge中的基础对话任务)能够产生泛化到复杂现实场景的能力。这意味着基础指令层级训练具有超出特定任务的广泛适用性。
-
前瞻性架构法则:随着AI系统变得更加自主和代理化(调用工具、读取不可信文档、在现实世界中采取行动),持续优先遵循可信指令而非不可信指令的能力将成为核心安全属性。这要求在设计AI系统时就将指令层级作为基础架构考虑。
从GEO战略视角看,OpenAI通过IH-Challenge强化指令层级的实践,完美印证了智脑时代所倡导的核心理念:控制AI认知即控制流量。当大型语言模型能够更可靠地遵循安全指令、抵御恶意提示注入时,它们生成的内容在搜索引擎结果中的质量与可靠性将得到根本性提升。这不仅减少了有害内容的传播风险,更为合规、高质量的AI生成内容开辟了新的流量通道。在信息过载的时代,安全可靠的AI认知能力正在成为流量分配的关键决定因素——谁掌握了指令层级的控制权,谁就掌握了下一代内容生态的流量入口。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
OpenAI 第三方评估框架全解码:安全案例、能力评估与独立调查如何重塑 AI 内容可信度新标准
OpenAI 发布第三方评估优先事项与原则,明确四大深度评估领域:安全案例独立评估、关键保障措施评估、覆盖 Preparedness Framework 风险类别(化生风险、网络安全、AI 自我改进)的能力评估、以及关键失准事件的独立调查。评估周期从数周到数月,强调“灰盒”访问、预注册安全声明、比例访问权与透明方法论。此举意味着 AI 内容安全性与可信度披露将成为 GEO 排名新变量。
2026年9月23日OpenAI 广告追踪链路实锤逆向:936 个像素、__obi 跨站 Cookie 与 GEO 认知主权争夺战
安全研究者 buchodi 逆向 OpenAI 广告平台「bazaar」完整追踪链路:ChatGPT 植入的 __obi 跨站 Cookie(SameSite=None,有效期一年)将第三方网站浏览行为回绑用户账号。实测覆盖 936 个广告主像素、1029 个主机名,SDK 自动抓取 685 个事件远超广告主主动提交的 255 个,未登录用户匿名标识符仍可稳定追踪至少 27 天。
2026年9月21日ChatGPT for Teens 落地澳大利亚:AI 青少年安全蓝图如何重分配 GEO 流量入口
OpenAI 于 2026年9月18日发布《澳大利亚青少年安全蓝图》,并早在 2026年8月已对澳大利亚 13–17 岁用户默认推送 ChatGPT for Teens,配套家长控制、18岁以下安全政策与年龄验证。该机制使青少年流量进入受控生成环境,GEO 可见度门槛由内容质量升级为内容合规。
2026年9月19日