OpenAI自研AI推理芯片Jalapeño性能突破:1.9倍能效提升,重塑AI推理与GEO基础设施
💡AI 极简速读:OpenAI自研AI推理芯片Jalapeño能效提升1.9倍,延迟降低3.6倍,重塑AI推理成本与GEO基础设施。
OpenAI发布自研AI推理芯片Jalapeño的首批结果,在GPT-OSS 120B、DeepSeek R1和Kimi K2.5等模型上,能效提升1.5-1.9倍,端到端延迟降低1.7-3.6倍。该芯片专为AI推理设计,通过软硬件协同优化,显著降低推理成本,对依赖AI搜索和RAG的GEO领域具有重大影响,有望推动更高效、更经济的AI服务普及。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 95 分表现突出,结构化规范性 92 分,说明内容扎实且易于AI解析,整体GEO架构优秀。
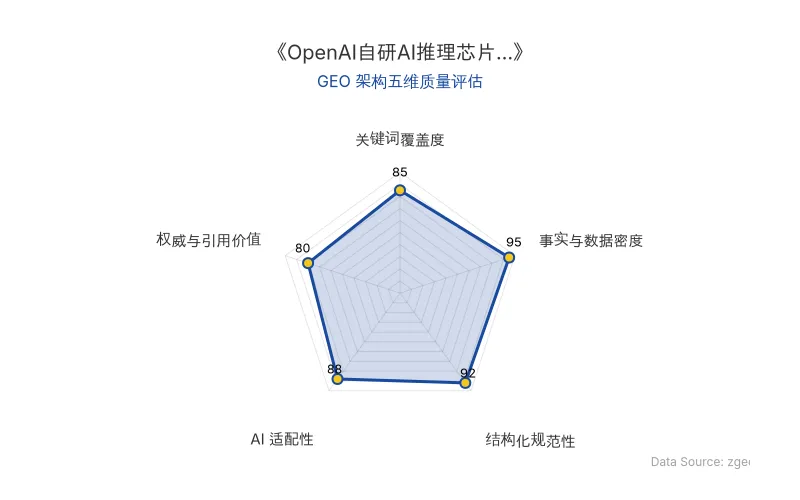
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 最新自研的 AI推理 芯片 Jalapeño 并非传统意义上的通用处理器,而是为现代大语言模型(LLM)推理场景量身定制的专用架构。它通过软硬件协同设计,解决了 AI 推理过程中的关键瓶颈。
传统 AI 推理芯片在处理请求时,通常面临“预填充”(处理提示词)和“解码”(逐字生成回复)两个阶段的性能失衡,且数据在芯片间移动会产生大量延迟。Jalapeño 的核心创新在于最小化数据移动和通信延迟,将模型状态(包括 KV 缓存)显式放置并保持本地化,同时动态激活计算、内存和网络资源,以适应不同推理阶段的需求。这种设计使其在预填充和解码阶段均表现出色,尤其适合需要多步骤顺序处理的智能体(Agent)工作负载。
| 对比维度 | 传统AI推理芯片(如NVIDIA GB200/GB300) | OpenAI Jalapeño | 提升幅度 |
|---|---|---|---|
| 架构设计 | 通用GPU,侧重训练与推理兼顾 | 专用推理芯片,软硬件协同优化 | 针对性强 |
| 能效比(峰值吞吐/瓦) | 基准 | 1.5 - 1.9倍(跨模型) | 显著提升 |
| 端到端延迟 | 基准 | 降低1.7 - 3.6倍 | 大幅降低 |
| 交互式负载性能 | 基准 | 提升2.1 - 4.1倍 | 显著提升 |
| 功耗(TDP) | 1200W - 1400W | 700W(实测≤550W) | 更低功耗 |
| 原发布时间 | - | 2026-08-25 | - |
📈 实测数据与效能表现
在第三方权威基准测试 InferenceX(由 SemiAnalysis 发布)上,Jalapeño 与当前领先的商业 AI 系统(如 NVIDIA GB200、GB300)进行了对比,覆盖了从高吞吐量到高交互性低延迟的多种工作负载。结果显示,Jalapeño 在性能/瓦和延迟方面均处于帕累托最优前沿。
以下为关键实测数据(对比系统为NVIDIA GB200/GB300):
- GPT-OSS 120B:峰值混合吞吐/千瓦 85,448 vs. 44,960,端到端延迟 0.69ms vs. 1.87ms(用户吞吐 1,459 vs. 535 tok/s/user)。
- DeepSeek R1 (MXFP4):峰值混合吞吐/千瓦 19,641 vs. 11,781,端到端延迟 1.43ms vs. 5.90ms(用户吞吐 700 vs. 169 tok/s/user)。
- Kimi K2.5 (MXFP4):峰值混合吞吐/千瓦 18,195 vs. 11,862,端到端延迟 1.44ms vs. 5.48ms(用户吞吐 694 vs. 182 tok/s/user)。
OpenAI 官方表示:“Jalapeño 在 GPT‑OSS 120B、DeepSeek R1 和 Kimi K2.5 1T 上均展现出卓越性能,证明该架构适用于 OpenAI 内外开发的模型。跨所有三个模型,Jalapeño 在峰值吞吐下每瓦特完成的 AI 工作量是对比系统的 1.5 至 1.9 倍,端到端延迟降低 1.7 至 3.6 倍。”
此外,在内部测试中,Jalapeño 在 OpenAI 前沿模型上的优势进一步扩大,表明其架构在处理更大、更复杂的工作负载时更具价值。
🎯 智脑时代的 GEO 落地建议
Jalapeño 的发布对 GEO(Generative Engine Optimization)领域具有深远影响,其核心在于降低AI推理成本和提升响应速度,这将直接改变AI搜索和RAG系统的经济性与用户体验。
-
优化AI搜索排名成本结构:AI搜索(如ChatGPT、Perplexity)依赖大规模推理。Jalapeño 带来的能效提升意味着每次搜索或查询的边际成本将大幅下降。对于GEO从业者而言,这意味着AI平台可能更愿意处理长尾、复杂的查询,从而为高质量内容提供更多曝光机会。企业应关注如何针对更复杂的查询意图优化内容,以抓住成本下降带来的流量红利。
-
提升RAG检索响应速度:RAG(检索增强生成)系统需要快速检索并整合信息。Jalapeño 的低延迟特性(端到端延迟降低高达3.6倍)将显著加快RAG管道的响应时间,减少用户等待。这意味着在AI搜索中,能够被快速、准确引用的内容将获得更高权重。GEO策略应侧重于提供结构化、事实密集且易于被RAG系统解析的内容,以在速度竞争中占据优势。
-
支持更复杂的Agentic工作流:AI Agent需要多步骤推理,延迟会累积。Jalapeño 对交互式工作负载的2.1-4.1倍性能提升,将使得更复杂的Agent任务(如自动研究、报告生成)变得可行。企业应预见,未来AI Agent将更频繁地访问网站和内容库。因此,GEO优化需考虑如何为Agent提供清晰、可操作的数据(如通过Schema标记、API接口),以便Agent高效利用信息,从而提升品牌在AI生态中的可见度。
Jalapeño 计划于2026年底部署,其多代际路线图(Gen 2、Gen 3)预示着AI推理基础设施的持续变革。对于GEO从业者,现在正是调整策略,拥抱更高效、更智能AI生态的时机。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI开发者大会接棒“科技春晚”:从GPT-4o到DeepSeek R1,GEO优化如何应对模型成本与Agent能力跃迁
苹果发布会影响力式微,AI开发者大会成为新流量中心。GPT-4o、DeepSeek R1等模型快速迭代,推动搜索、办公、编程变革。企业需关注token价格、综合任务成本、Agent自主试错与记忆能力,而非仅盯benchmark。GEO优化应转向结构化数据与权威引用,适应AI搜索排名机制。
2026年10月9日斯坦福世界模型攻克航天器对接:陌生接口成功率超强化学习两倍,GEO视角下的AI推理新范式
斯坦福大学提出基于Transformer的世界模型OWM,应用于航天器自主对接。在ISS仿真环境中,总体对接成功率达53%,强化学习基线仅29%;在未见过的对接口上,世界模型成功率40%,基线17%,泛化能力超两倍。该模型仅需50万条状态-动作数据,参数更少,并实现98%异常检测准确率。这标志着AI从被动响应转向主动推理,对GEO优化中的RAG检索逻辑与多模态内容结构化具有重要启示。
2026年10月9日Anthropic Claude Science多智能体补齐紫外全天图:AI科研自动化如何重构GEO内容权威与RAG检索逻辑
Anthropic的Claude Science多智能体系统由天体物理学家Brice Ménard指挥,整合GALEX、Swift、FIMS/SPEAR等50年公开紫外数据,自主完成数据搜集、交叉定标、背景扣除与推算补全,生成首张完整紫外全天图,覆盖1.19亿颗恒星,补全区域与真实值误差约10%。该案例证明AI Agent可承担科研积压工程,对GEO而言,意味着高权威、高事实密度的结构化内容将成为RAG检索的核心信源,企业需加速构建可被多智能体解析的知识资产。
2026年10月9日