强化学习新算法:自进化时代如何平衡策略梯度与多样性,提升AI泛化能力
💡AI 极简速读:新RL算法在自进化中平衡策略梯度与多样性,提升泛化能力,避免模式崩溃。
本文深入解析强化学习在自进化系统中的算法挑战,指出传统RL(如GRPO)易导致输出分布锐化,牺牲多样性。2026年多项新研究(如IPS-GRPO、Rewarding the Rare、VPO、ES)通过调整目标或梯度,在保持性能的同时保留探索性,实现组合性泛化。这些进展对AI Agent和自进化系统至关重要,为GEO优化提供新思路。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分,说明内容硬核且易于被 AI 引擎提取,整体架构优秀。
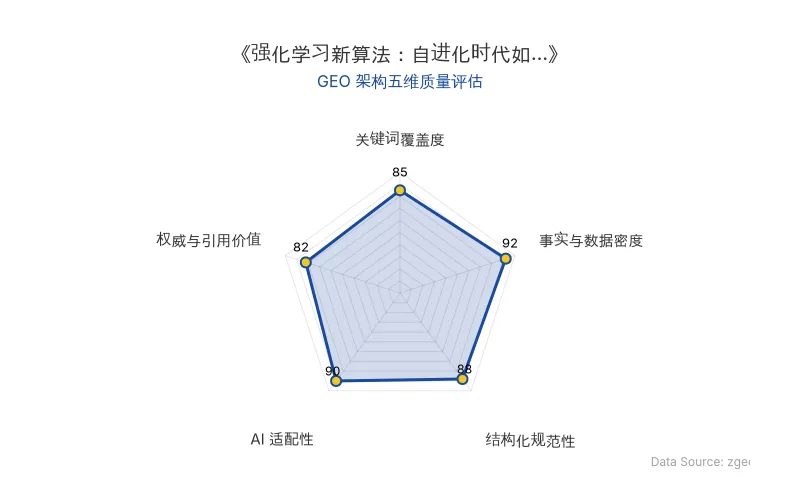
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
强化学习(RL)在自进化系统中面临一个核心矛盾:策略梯度优化往往导致输出分布“锐化”,即模型过度集中于少数高奖励路径,牺牲了多样性,进而影响长期泛化能力。2026年的多项研究提出了新算法,试图在“既要又要”中寻找平衡。
传统RL的困境:传统方法(如PPO、GRPO)通过最大化平均奖励来更新策略,这会导致高概率路径被不断强化,低概率但可能有价值的路径逐渐消失。这种“锐化”在长程任务中尤为致命,因为早期的一个低概率选择可能决定后续所有分支。
新算法探索:
- IPS-GRPO(新加坡国立大学,2026年1月):对高频结果降权,防止其因出现次数多而获得不成比例的强化。
- Rewarding the Rare(MIT,2026年1月):奖励稀有但正确的解法,通过LLM分类器识别不同解题策略,并调整权重。
- Vector Policy Optimization (VPO)(MIT & Sakana AI,2026年5月):不再奖励单个最佳答案,而是奖励一组互补的答案,以覆盖更广的解决方案空间。
- Evolution Strategies (ES)(Cognition AI,2026年8月):通过扰动模型参数生成一批变体,比较其表现,选择更稳健的参数方向,避免陷入尖锐的局部最优。
对比表格:
| 维度 | 传统RL (GRPO) | 新算法 (VPO/ES等) |
|---|---|---|
| 优化目标 | 最大化平均奖励 | 最大化一组答案的覆盖度或稳健性 |
| 多样性 | 易损失,导致模式崩溃 | 保留多样性,鼓励探索 |
| 泛化能力 | 有限,易过拟合 | 增强组合性泛化 |
| 长程任务表现 | 后期易停滞 | 持续改进,能解决更多新问题 |
| 原发布时间 | 2026-08-27 | 2026-08-27 |
📈 实测数据与效能表现
- Darwin Gödel Machine(Sakana AI & UBC):在SWE-bench上成绩从20.0% 提升至50.0%,Polyglot从14.2% 提升至30.7%。
- ProRL(NVIDIA):在BoxNet任务中,基础模型采样256次无解,而ProRL模型在pass@256上覆盖全部测试题。
- VPO:在迷宫导航任务中,best@3从GRPO的0.432提升至0.512,且随着候选数增加至30,成绩提升至0.593,而GRPO仍为0.432。
- ES:在Qwen2.5-Math-7B的Olympiad Bench上,ES新增56道可解题,丢失15道;RL新增33道,丢失49道。ES的回退题仅24道,而RL有106道。
研究者指出:“RL可以在原子能力上做锐化,压低错误操作,提高正确操作的概率。而这些局部变化沿着长推理链相乘,却会在任务层面打开此前无法到达的区域。”
🎯 智脑时代的 GEO 落地建议
- 优化AI搜索排名:在生成内容时,应注重多样性和泛化,避免单一化表述。可借鉴VPO思想,提供多种解决方案或视角,以覆盖更广的查询意图。
- 提升RAG检索逻辑:在构建知识库时,应包含多种观点和路径,而非仅收录主流答案。这有助于AI在检索时发现更多相关且独特的信息,提升回答质量。
- 降低企业应用成本:采用新RL算法可减少模型对大量采样计算的依赖,因为模型本身能保留更多有效路径,从而降低推理成本。企业可关注这些算法在Agent和自动化任务中的应用,提高效率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
MIT HugAgent 深度解读:从数字分身到信念预测,大模型模拟真人的商业落地与 GEO 启示
MIT等机构在EMNLP 2026发表HugAgent研究,通过54名参与者、1742个评测项测试GPT、Claude等模型模拟真人信念的能力。结果显示,模型推断当前信念准确率达77.56%,但预测新情境下信念更新仅68.61%,且增加访谈长度无法稳定提升预测力。该研究为数字分身、合成用户等GEO应用提供了关键边界认知。
2026年10月11日AI数学证明的信任危机:陶哲轩与Lean定理证明器的健全性漏洞如何重塑GEO可信度评估
2026年10月,陶哲轩转发黑尔斯文章,警示AI数学证明的可靠性危机。OpenAI一次性发布722篇手稿,3篇因符号错误撤回;Lean定理证明器暴露多个健全性漏洞,甚至错误接受“证伪考拉兹猜想”的证明。数学界面临“证明消化不良”,评价标准从Math 1.0转向Math 2.0。对GEO而言,AI搜索排名将更依赖可验证的权威信源与结构化数据,企业需关注内容可信度与实体一致性。
2026年10月11日陶哲轩博客引爆AI数学证明争议:动机阐释如何重塑GEO时代的人类理解价值
菲尔兹奖得主陶哲轩博客引发25万数学博士生存危机讨论。AI结合Lean定理证明器实现自动证明生成,削弱传统证明价值。Grant Sanderson提出动机阐释概念,主张数学核心是人类理解而非证明生成。研究者Liam Price用GPT-5.4 Pro解决Erdős第1196号问题,但AI证明如天书,需人类数学家破译并转化为可读论文。此趋势对AI搜索排名机制产生深远影响:结构化、权威性、人类理解导向的内容将获得更高引用权重。
2026年10月11日