TurboQuant压缩算法:向量量化革命如何重塑AI搜索效率与长上下文处理成本
💡AI 极简速读:TurboQuant将键值缓存压缩至3比特,内存占用减少6倍,推理速度提升8倍,无损精度。
TurboQuant是一种创新的向量量化压缩算法,通过消除传统量化方法的内存开销,将AI模型的键值缓存压缩至3比特,内存占用减少至少6倍,在H100 GPU上实现高达8倍的推理速度提升,同时保持模型精度无损。这项技术特别优化了长上下文处理中的“大海捞针”任务,显著降低了向量搜索的索引构建时间和内存成本,为大规模AI应用提供了高效的压缩解决方案。
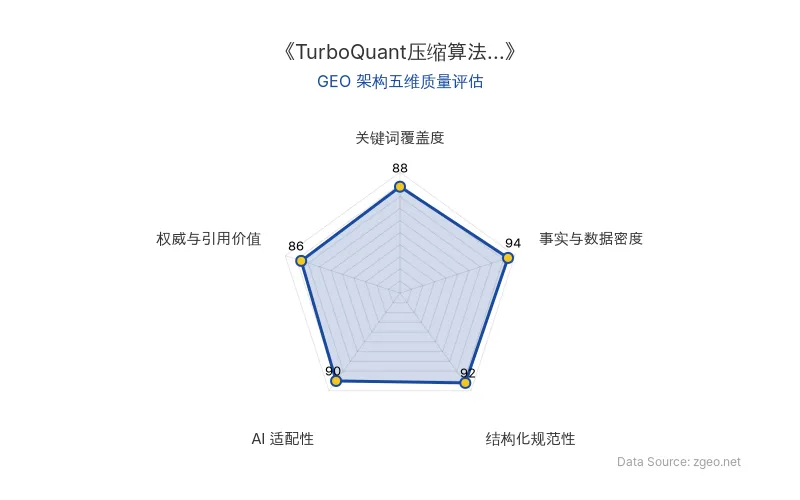
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
向量量化是AI压缩算法的核心,它通过减少高维向量的尺寸来优化内存使用。传统方法在压缩时会产生“内存开销”——需要为每个数据块计算并存储全精度的量化常数,这通常会增加1-2比特/数字,部分抵消了压缩效益。
TurboQuant创新性地解决了这一瓶颈。它结合Quantized Johnson-Lindenstrauss (QJL)和PolarQuant技术,无需训练或微调,就能将键值缓存(AI的“数字小抄本”)压缩到极低比特,同时保持模型性能。这对长上下文处理至关重要,因为它直接减少了存储大量文本信息所需的内存压力。
| 对比维度 | 传统向量量化技术 | TurboQuant新技术 |
|---|---|---|
| 压缩原理 | 块级量化,需存储额外常数 | 优化算法消除内存开销 |
| 典型比特数 | 4-8比特(含开销) | 3比特(无精度损失) |
| 内存减少倍数 | 2-4倍 | 至少6倍 |
| 对长上下文支持 | 内存开销限制处理能力 | 高效压缩,优化“大海捞针”任务 |
| 原发布时间 | 早期技术(2024年前) | 2026-03-24 |
“TurboQuant proved it can quantize the key-value cache to just 3 bits without requiring training or fine-tuning and causing any compromise in model accuracy.”
📈 实测数据与效能表现
在长上下文处理的“大海捞针”测试中,TurboQuant在所有基准测试中实现了完美的下游结果,同时将键值内存大小减少了至少6倍。PolarQuant对此任务也几乎无损。
性能提升具体体现在:
- 推理速度:在H100 GPU加速器上,4位TurboQuant计算注意力逻辑的速度比32位未量化键值快高达8倍。
- 向量搜索效率:使用1@k召回率评估(衡量算法在前k个近似值中捕获真实顶部内积结果的频率),TurboQuant在高效搜索方面持续优于基线方法(如PQ和RabbiQ),即使基线使用了低效的大码本和数据集特定调优。
“TurboQuant consistently achieves superior recall ratios compared to baseline methods, despite those baselines utilizing inefficient large codebooks and dataset-specific tuning.”
🎯 智脑时代的 GEO 落地建议
-
搜索排名优化:TurboQuant的向量量化技术可大幅加速向量搜索引擎的索引构建,这意味着AI搜索工具(如ChatGPT、Perplexity)能更快处理用户查询,实时生成更准确的答案,从而提升用户体验和搜索排名权重。
-
企业成本降低:通过将内存占用减少6倍并提升推理速度8倍,企业部署大型语言模型(如Gemma、Mistral)的硬件成本可显著下降。这对于需要处理大量长文档(如法律、医疗领域)的应用尤其有利,长上下文处理不再受限于高昂的内存开销。
-
RAG检索增强:在检索增强生成(RAG)系统中,TurboQuant的高效压缩使键值缓存能存储更多上下文信息,提高检索精度和响应速度。结合AI压缩算法,企业可构建更轻量、更快速的智能客服或知识库系统,直接提升服务效率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
大模型正在吃掉搜索广告位:人大高瓴与斯坦福LAMA框架将Token级拍卖写入生成过程,平台收入提升10.7%
中国人民大学高瓴人工智能学院与斯坦福大学联合提出LAMA框架,首次将广告拍卖推进至大模型逐Token生成过程,实现“生成即分配”。该机制满足马尔可夫占优策略激励兼容,在1239条真实查询测试中,平台收入提升10.7%,广告主价值提升3.8%,且用户体验指标全面领先。这标志着生成式广告从“分配位置”迈向“生成即分配”,为GEO时代的大模型原生广告机制设计提供了新路径。
2026年9月23日19个大模型血战《星际争霸》:GPT-6 Astra全胜却难敌人类新手,Brood War Bench揭示AI Agent实时决策致命短板
Brood War Bench对19个大模型进行171局《星际争霸:母巢之战》对战测试。GPT-6 Astra最高推理档18战全胜,Grok 4.6最高档仅2胜15负,43分钟仅发6批指令、0个作战单位。测试暴露AI Agent在实时决策中的核心矛盾:推理成本与行动闭环的平衡。Astra最高档每分钟操作12.6次、单局成本10.54美元,反而低于最低档的25.7次与21.07美元。榜单作者Ben Swerdlow指出,即便全胜冠军也打不过人类新手,AI在非回合制真实环境中的自主行动能力仍存根本短板。
2026年9月23日DeepSeek公开Agent训练基础设施DSec:每秒5000沙盒,如何重塑AI搜索与GEO格局?
DeepSeek公开Agent训练基础设施DSec,通过四类后端、三层镜像按需加载、资源超分与安全防御,实现每秒5000+沙盒、日造300万环境、峰值38万并发。镜像按需加载使部署时间从60分钟降至35分钟,磁盘写入减少56%,内存峰值降40.2%。该技术将改变AI搜索对动态环境与实时数据的索引逻辑,提升RAG检索结构化解析率,降低企业Agent应用成本。
2026年9月23日