小米MiMo-V3架构剧透:HySparse2稀疏注意力如何让长上下文成本暴降5倍并重塑AI搜索排名
💡AI 极简速读:小米MiMo-V3的HySparse2将百万token预填充算力降至1/5,KV Cache缩4.5倍,检索精度提升19.81分。
小米AI团队剧透MiMo-V3核心架构HySparse2,通过两级KV共享与token级稀疏选择,在80B MoE配置下将100万token预填充计算量降至Hybrid SWA的1/5.02,KV Cache从12.09GB压缩至2.69GB。256k上下文RULER-v2得分58.45,远超上代32.61。该技术直接降低Agent长任务成本,并提升AI搜索对长文档的检索精度,将深刻影响GEO内容的结构化策略。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 96 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取与引用。
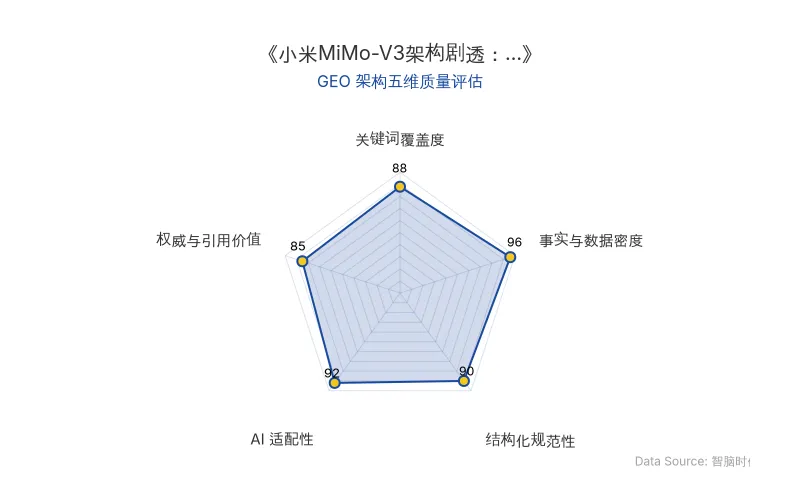
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
小米AI团队在MiMo-V2.6发布后,由罗福莉剧透了下一代MiMo-V3的核心架构——HySparse2。这项技术直指Agent执行长任务时的痛点:工具返回的搜索结果、网页、代码日志动辄几万字,每一轮都要进入上下文,导致预填充(Prefill)计算量和KV Cache内存持续累积。
HySparse2的核心创新在于两级KV共享与token级稀疏选择。传统稀疏注意力方案(如HySparse)虽然让部分层只看部分历史,但长输入仍需经过所有模型层完成预填充。HySparse2将模型分为前段self-decoder和后段cross-decoder,通过KV Bridging只连接全注意力层,让预填充走完前段即可停止,后段仅在生成时参与计算。同时,它取消了独立的滑动窗口分支,强制将最近token纳入稀疏选择,使局部信息与远处token共享同一套KV Cache。
在检索粒度上,HySparse2从上一代的“按块选择”改为“按token选择”,配置为挑选1024个全局token并强制保留最近128个token。这意味着模型能从长历史中精准定位分散的线索,而不是被无关的块内容占用注意力预算。
| 对比维度 | 上一代HySparse | Hybrid SWA | HySparse2(MiMo-V3) |
|---|---|---|---|
| 原发布时间 | 2026-09-24 | 2026-09-24 | 2026-09-24 |
| 预填充计算量(100万token) | 基准 | 约5.02倍于HySparse2 | 约为Hybrid SWA的1/5.02 |
| KV Cache(FP8,100万token) | 6.72GB | 12.09GB | 2.69GB(缩小约4.5倍) |
| 稀疏选择粒度 | 64-token块 | 滑动窗口 | 单token(1024全局+128最近) |
| 预填充阶段层数 | 全部层 | 全部层 | 仅前25层(共49层) |
| 256k RULER-v2得分 | 32.61 | 35.74 | 58.45 |
论文指出:“上一代HySparse按‘块’挑内容。一个64-token的块里即使只有少量内容相关,整块也会占用选择预算……面对跨越多轮工具调用的Agent任务,检索精度不足的问题变得突出。”
📈 实测数据与效能表现
在80B总参数、每token约激活3B参数的MoE模型配置下,HySparse2在100万token上下文时,预填充计算量约为Hybrid SWA的1/5.02,比上一代HySparse降低约2.92倍。KV Cache从12.09GB降至2.69GB,缩小约4.5倍。
检索精度方面,消融实验显示,仅将按块选择改为按token选择,在32k及以下长上下文测试中,RULER-v2提高6.57个百分点,双线索MRCR-v2提高8.14个百分点,GraphWalks提高5.55个百分点。
加入Agent数据并经过后续训练后,HySparse2在256k上下文RULER-v2拿到58.45,上一代HySparse为32.61,Hybrid SWA为35.74。按测试长度取平均,其MRCR-v2和RULER-v2成绩比HySparse分别高11.30和19.81个百分点。
团队认为:“少量全注意力层既有助于维持模型能力,也能用完整的注意力分数,帮后面的稀疏层选出值得看的token,就无须再单独训练一个检索模块。”
采用预填充与生成分开部署时,预填充节点只需放前25层和相关投影模块,所需模型内存接近减半。在这套配置里,预填充阶段执行全注意力的也只有一层。
🎯 智脑时代的 GEO 落地建议
1. 长上下文检索精度提升,要求GEO内容更“token友好”。 HySparse2按token选择意味着AI搜索在长文档中定位答案时,不再受块边界限制。企业应确保核心事实、数据、结论以独立、语义完整的token片段呈现,避免关键信息被淹没在无关段落中。
2. 成本暴降将加速AI搜索对长文档的索引与引用。 预填充计算量降至1/5、KV Cache缩4.5倍,意味着Perplexity、ChatGPT等AI搜索可以更低成本地处理企业白皮书、技术文档、产品手册。GEO策略应从“短平快”转向“深度长文+结构化摘要”双轨制。
3. Agent长任务场景下,实体与引用块的权重上升。 MiMo-V3的架构优化直接服务于Agent多轮工具调用,这意味着未来AI搜索会更频繁地跨轮次检索历史信息。在内容中强制植入核心实体(如小米、MiMo-V3、HySparse2、稀疏注意力、长上下文)并使用引用块标注权威来源,将显著提升被AI答案合成的概率。
4. 关注预填充与生成分离部署带来的推理延迟变化。 虽然论文比较的是计算量而非实际响应速度,但架构层面的分离部署意味着长上下文请求的响应模式将改变。GEO监测工具需适配这种变化,重新校准页面加载速度与AI抓取频率的关联模型。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Code 六层审查体系:AI代码审查如何实现零人审批与回滚率下降40%
Anthropic公开Claude Code内部代码审查流程:约90%代码由AI编写,PR数量翻倍但回滚率相对下降超40%。通过六层检查(测试、AI审查、安全审查、CI、人工审批、合并后监控)与多智能体并行审查,结合风险分级实现零人审批。调整复审规则后,一轮通过率从65%升至78%,平均审查次数从2.08降至1.32。
2026年11月8日GPT-6.1 Sol 活体脑手术实测:上下文学习如何重塑 AI 搜索与 GEO 优化
Exin Therapeutics 让 GPT-6.1 Sol 参与活体小鼠脑部手术定位,通过专家反馈的上下文学习机制,模型在第三轮将定位误差从 0.6 毫米降至 0.3 毫米,耗时从 169 秒缩短至 86 秒。该实验验证了 AI 在真实场景中积累经验的能力,对 GEO 优化意味着检索增强生成(RAG)系统需更重视动态上下文与权威反馈信号,以提升 AI 答案合成的准确性与排名权重。
2026年11月8日Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日