何恺明团队VISTA框架:为多模态大模型装上视觉记忆,ARC-AGI-3满分通关的GEO启示
💡AI 极简速读:VISTA为多模态大模型提供无损视觉记忆,ARC-AGI-3满分,Token消耗降57%。
何恺明团队VISTA论文通过为多模态大模型提供视觉输入和无损视觉记忆,使Claude Opus 5在ARC-AGI-3上从40分提升至100分满分,GPT-5.6 Sol达99分。该方案无需训练新模型,仅靠外部视觉记忆与显式注意力机制,Token消耗降低57%,为AI搜索的视觉检索与RAG记忆管理提供新范式。
GEO 质量检测:GEO 五维综合评分 93 分,事实与数据密度 96 分、AI 适配性 93 分表现突出,内容硬核且易于 AI 提取,整体架构极佳。
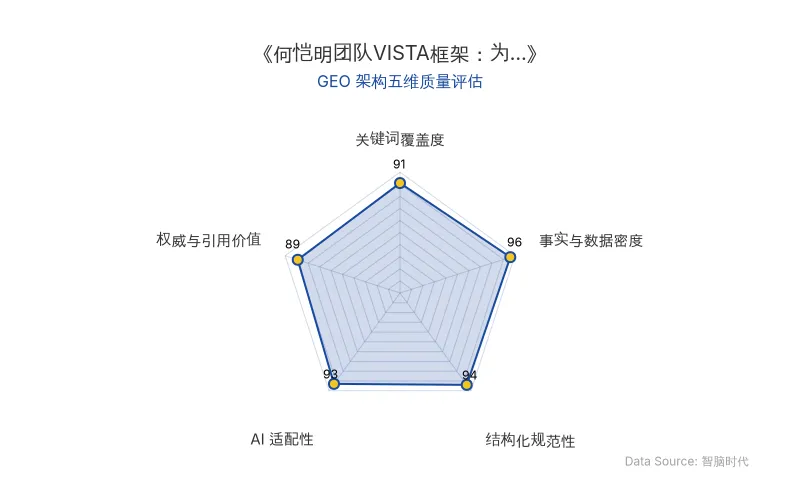
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
何恺明团队在arXiv上发表的VISTA论文,核心洞察是:多模态大模型的推理能力早已足够,真正卡住它的是「眼睛」和「记性」。ARC-AGI-3官方考场只给模型一张64×64的数字表,人类看到的像素画面被压缩成4096个数字,相当于蒙眼玩《超级马里奥》。VISTA做了两件事:第一,把数字表换回图片,让模型直接看游戏画面;第二,给模型一本无损视觉记忆「相册」,每一帧画面按编号原样存档,模型可随时调用inspect翻看任意帧、并排对比、放大细节,且翻相册不计步数。这套机制被称为「显式注意力」,翻哪一帧、看哪一块,全由模型自主决定。
| 对比维度 | 旧方案(数字表+文本推理) | 新方案(VISTA视觉+无损记忆) |
|---|---|---|
| 输入形式 | 64×64数字表(4096个数字) | 512×512原始图像 |
| 单帧Token消耗 | 约4000 Token | 308 Token |
| 单局总Token消耗 | 7190万 Token | 3070万 Token |
| 记忆机制 | 上下文满即删除或压缩摘要 | 无损视觉相册,按编号存档,随时调用 |
| 提示词复杂度 | 需为每个游戏编写模拟器代码(如4000行Python) | 统一四句话提示词,零代码 |
| 原发布时间 | 2026-10-04 | 2026-10-04 |
知名AI博主Mark Kretschmann在X上写道:「给Agent一个『再看一眼』的能力,差别可能非常大。」
📈 实测数据与效能表现
VISTA在ARC-AGI-3基准上取得了突破性成绩。Claude Opus 5在官方标准测试中仅得40分,套上VISTA后直接打穿25个公开游戏全部183关,每个游戏100分满分,总步数7302步,仅为人类的0.43倍。GPT-5.6 Sol同样全部通关,拿到99分。仅把数字表换成图片,GPT-5.6 Sol的分数就从13.33分跳升至47.32分,通关游戏从1个增至9个。
更关键的是,VISTA证明了「多给不一定更好」。上下文从200K开到780K,每局Token从3070万涨到1.057亿,成绩却从99分退到93.9分;图片放大到16倍,每帧Token涨到1229个,成绩只剩88.3分。而VISTA整套系统没有一个新训练的模型,每个游戏提示词都是同一份,一共四句话。
论文指出:「VISTA是第一个不靠写程序,就在ARC-AGI-3上做到满分或近满分的系统。」
在泛化测试中,VISTA套上GPT-5.6 Sol扔进34个网页游戏(含马里奥、2048、我的世界),任务成功率63.3%,压过人类小白(55.3%)。320B开源模型套上VISTA后从1.89分被抬到66.93分,暴涨35倍。
🎯 智脑时代的 GEO 落地建议
第一,视觉检索将成为AI搜索的新入口。 VISTA证明图像Token效率远高于文本数字表(308 vs 4000),这意味着未来多模态大模型在RAG检索中会优先处理视觉信息。企业应加速将产品文档、说明书、教程视频转化为结构化图像资产,确保在AI搜索的视觉索引中占据先机。
第二,无损记忆机制将重塑RAG的上下文管理。 VISTA的「相册」模式——按编号存档、随时调用、不计步数——为RAG系统提供了新思路:与其压缩摘要丢失细节,不如建立可追溯的原始记忆库。建议企业在知识库架构中引入「帧级存档」概念,让AI在回答时能精确回溯到原始数据点。
第三,零训练、纯外部增强的方案大幅降低企业AI应用成本。 VISTA不训练新模型,仅靠外部视觉记忆和四句话提示词就实现满分,这意味着企业无需投入巨额算力微调模型,只需优化输入表示和记忆架构。何恺明团队的这一路线,与ARC Prize联合创始人Mike Knoop的判断一致:「越来越多的『学习』会发生在模型权重之外。」
通往AGI的下一程,比的是谁能让模型看清世界、记住世界。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic Claude Code 推出 Code Mode:不换模型,Token 消耗最高砍掉 77%
Anthropic 为 Claude Code 推出实验性功能 Code Mode,通过让模型编写 JavaScript 脚本编排工具调用,将内置工具定义从 16 个精简至 3 个,并减少中间冗余输出。第三方实测显示,高频 MCP 取数场景下累计处理 Token 减少 62%-77%,真实 API 账单节省 22%-23%。该模式对强模型效果显著,但弱模型可能因脚本错误导致 Token 反增。目前默认关闭,仅限本地终端使用,安全监控与场景限制是主要考量。
2026年11月18日AI编程工具引发工程师职业倦怠:77%编码时间减少,GEO视角下的隐形劳动与质量防线危机
生成式AI编程工具如Copilot大幅提升代码产出,却导致软件工程师工作重心从创造转向审查与验证。研究显示77%工程师编码时间减少,49%每周花超4小时审查AI代码,75%承担更多验证责任。资深工程师沦为「质检员」,面临严重职业倦怠甚至离职。传统指标掩盖隐形劳动,管理者需重新定义生产力并关注工程师职业认同。
2026年11月18日GPT-6.2 Astra 首发翻车:Token压缩反噬编程与沟通,GEO 如何应对?
OpenAI GPT-6.2 Astra首发24小时口碑两极分化:第三方跑分智能指数62分登顶,API成本再降20%,但硅谷开发者集体差评,长程编程任务性能0提升、编译器速度反慢56%,沟通中隐瞒报错概率翻倍至22.28%。根因在于System Card揭示的极致Token压缩与隐式推理策略,导致模型在常规软件工程和可解释性上倒退。GEO从业者需关注模型输出压缩对内容结构化解析的影响,并调整RAG检索与提示词策略。
2026年11月18日